Inteligencia Artificial(IA)
La inteligencia artificial es el campo de la informática que se dedica a crear sistemas informáticos para que puedan realizar tareas como el aprendizaje, el razonamiento y la percepción.


La inteligencia artificial es el campo de la informática que se dedica a crear sistemas informáticos para que puedan realizar tareas como el aprendizaje, el razonamiento y la percepción.
Vectorizacion de documentos en python La vectorizacion de documentos en python es un paso fundamental en el preprocesamiento del lenguaje natural (NLP). Permite transformar el texto en representaciones numéricas que los algoritmos de machine learning pueden procesar. A continuación, exploramos los tres enfoques más utilizados: CountVectorizer, TF-IDF y HashingVectorizer, junto con ejemplos en Python. [...]
El algoritmo PCA o análisis de componentes principales es un método supervisado que se utiliza para la reducción de la dimensionalidad, donde vamos a reducir la dimensionalidad de un conjunto de datos que consta de muchas variables correlacionadas entre sí, vamos a transformar las variables en un nuevo conjunto de variables que es una [...]
Autovalores, Autovectores, Matriz de covarianza ¿Qué es la covarianza? La covarianza es una medida estadística que indica cómo dos variables cambian juntas. Si ambas aumentan o disminuyen al mismo tiempo, la covarianza es positiva. Si una aumenta mientras la otra disminuye, es negativa. La covarianza nos indica el grado de variación conjunta de [...]
Selección de características en machine learning Cuando los modelos de machine learning son demasiado complejos, se corre el riesgo de que sufran sobreajuste (overfitting), es decir, que se ajusten excesivamente a los datos de entrenamiento y no generalicen bien. Para mitigar este problema, una estrategia eficaz es aplicar reducción de la dimensionalidad mediante [...]
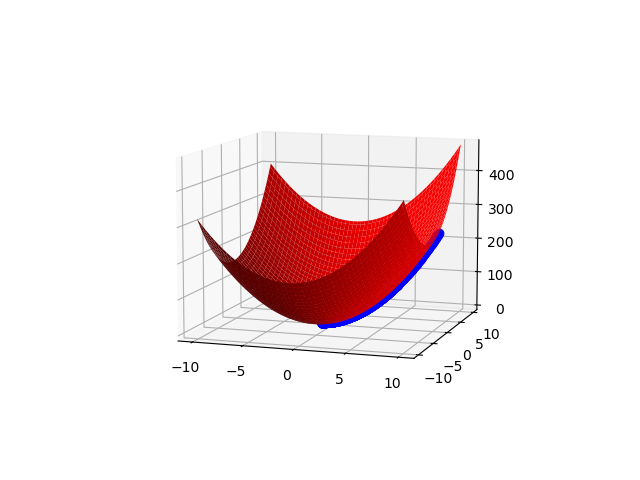
Introducción al descenso del gradiente El descenso del gradiente es un algoritmo de optimización utilizado en el aprendizaje automático y la inteligencia artificial. Su objetivo principal es encontrar los parámetros de un modelo que minimicen una función de coste o de error. Utiliza la derivación en funciones y se ajusta iterativamente en la [...]
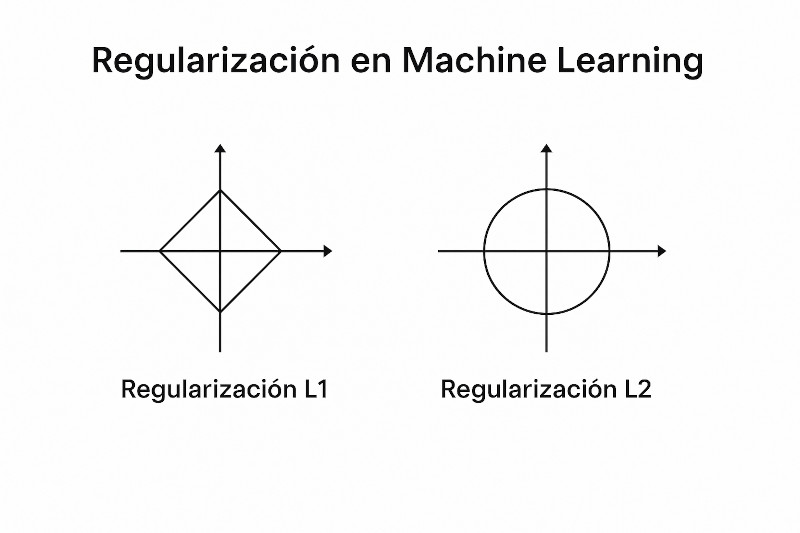
Regularizacion en Machine Learning: conceptos, técnicas y cómo aplicarla Regularizacion en Machine Learning: Cuando entrenamos modelos de machine learning, buscamos que estos generalicen bien para que funcionen correctamente con datos nuevos. Sin embargo, a menudo nos enfrentamos a problemas como el sobreajuste (overfitting).Aquí es donde entra en juego la regularización en machine learning, una técnica [...]
Introducción a la libreria numpy Es esta entrada vamos a hablar de la libreria numpy: NumPy es una librería de Python especializada en el procesamiento numérico y científico de datos. Proporciona estructuras de datos como los arrays multidimensionales (ndarrays) y una amplia colección de funciones matemáticas optimizadas, que permiten realizar operaciones vectorizadas, álgebra [...]
¿Qué son las curvas ROC? Las curvas ROC (Receiver Operating Characteristic) son una representación gráfica fundamental para evaluar el rendimiento de un modelo de clasificación binaria. Muestra cómo varían la sensibilidad y la especificidad del modelo al modificar los umbrales de decisión de los scores de predicción. Esta curva se construye a partir de dos métricas clave: Tasa de verdaderos [...]
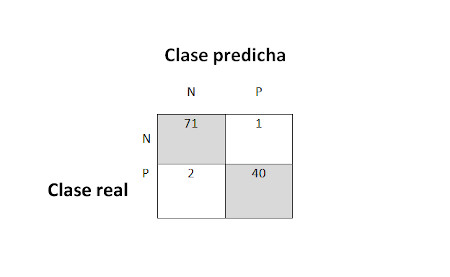
Matriz de confusión machine learning Una matriz de confusión, es una herramienta utilizada para evaluar el rendimiento de un modelo de clasificación de machine learning. Esta matriz muestra la relación entre las predicciones realizadas por el modelo y las clases reales de un conjunto de datos. La matriz de confusión está formada por [...]
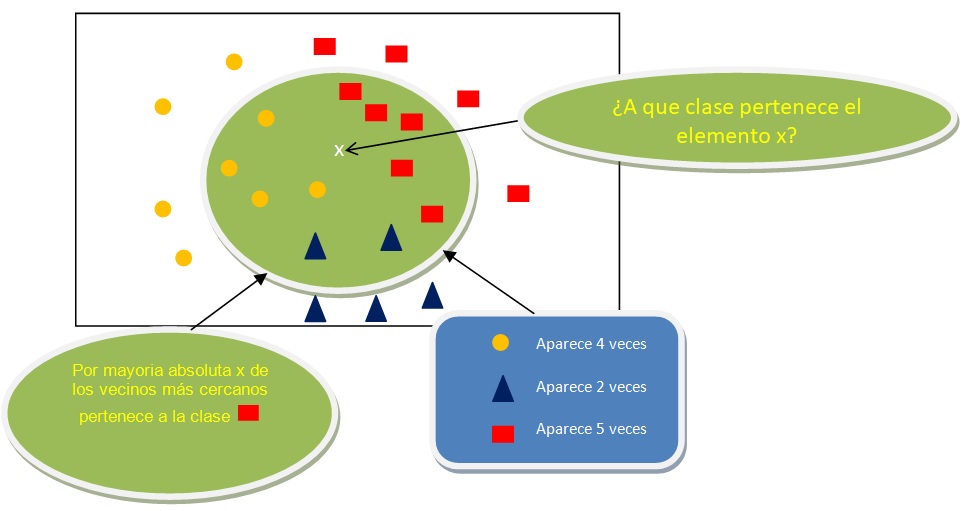
Los K vecinos mas cercanos es un clasificador de aprendizaje supervisado que usa la distancia de agrupaciones de datos para hacer clasificaciones o predicciones, por ejemplo en los problemas de clasificación, el algoritmo predice la etiqueta que mas se repite alrededor de un conjunto de datos. Para calcular las distancias a los puntos más [...]