Clasificadores en machine learning

En el campo del machine learning, los clasificadores son modelos que permiten predecir la clase o categoría a la que pertenece una muestra, a partir de sus características. Los clasificadores en machine learning utilizan estos datos para establecer reglas de decisión y separar las clases de forma automática.

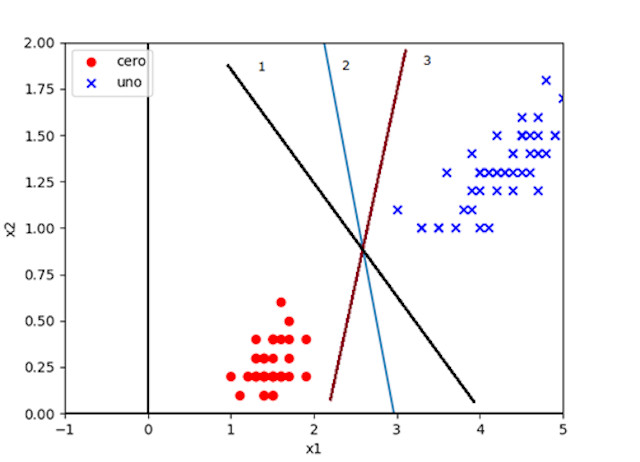
Uno de los métodos más conocidos son los clasificadores lineales, que buscan un hiperplano que actúe como límite entre clases. Si el conjunto de datos tiene dos características, este hiperplano es una línea recta; en espacios tridimensionales, se convierte en un plano que separa los puntos de forma clara.

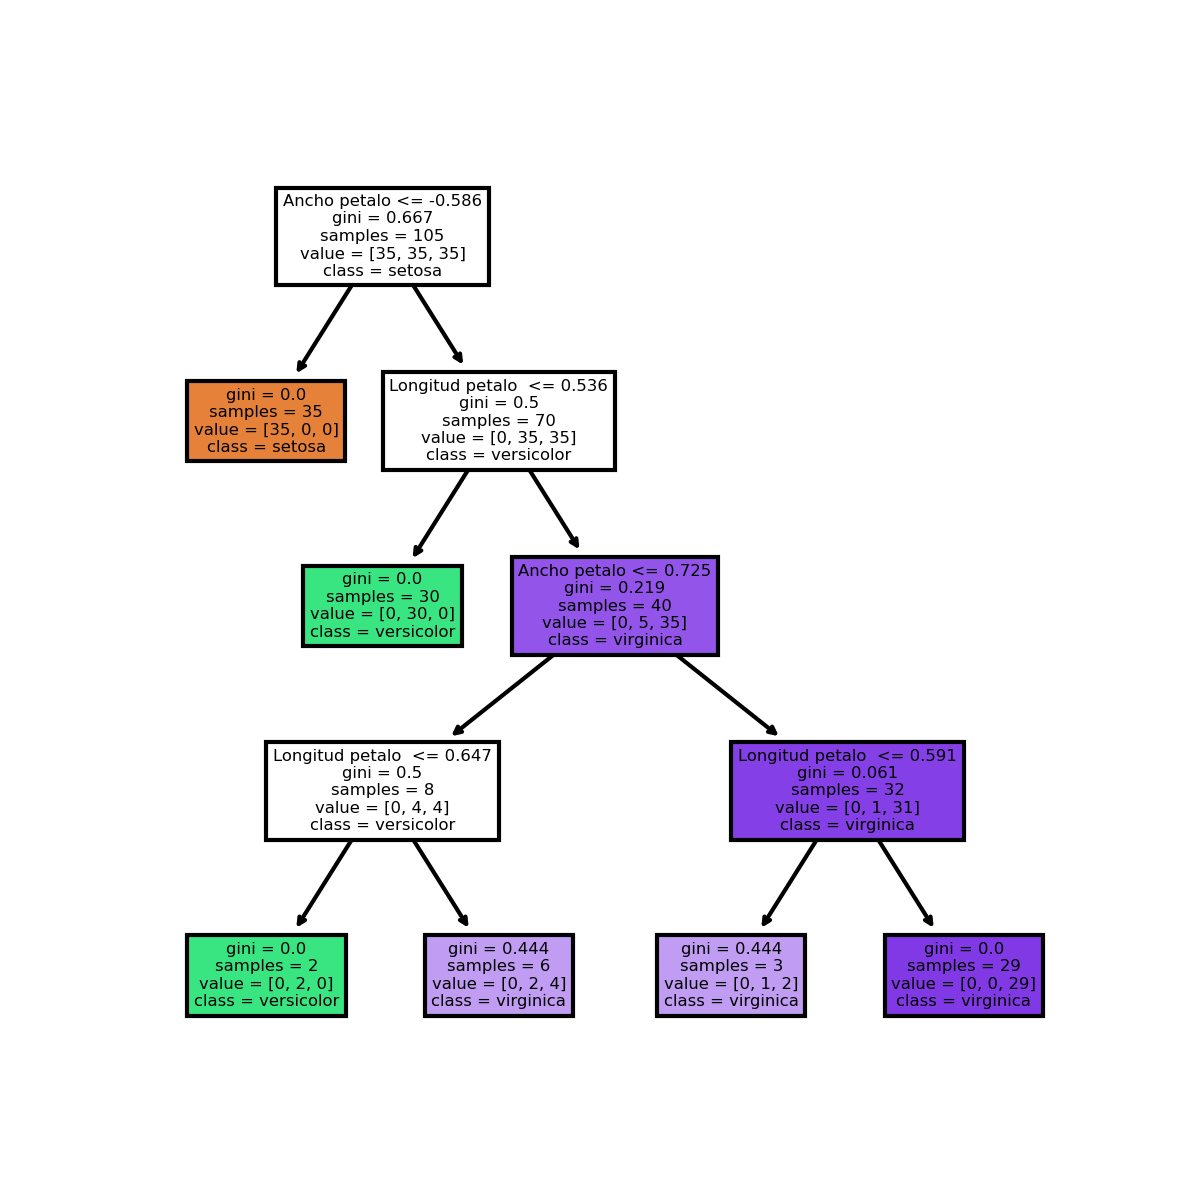
Por otro lado, los árboles de decisión son clasificadores que dividen el espacio de características en regiones homogéneas. Esto se logra a través de divisiones sucesivas que generan una estructura en forma de árbol, facilitando la clasificación de nuevas muestras según sus atributos.
Aprendizaje conjunto

Por |2025-09-05T20:55:38+02:00noviembre 3rd, 2023|

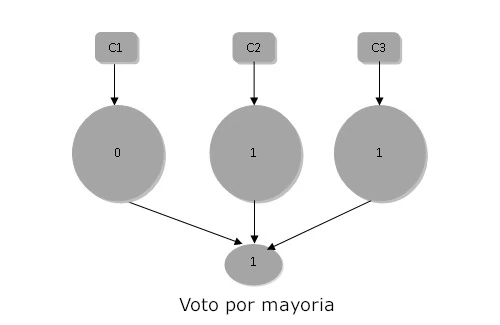
Aprendizaje conjunto ¿Qué es el aprendizaje conjunto (Ensemble Learning)? El aprendizaje conjunto es una técnica avanzada de machine learning que consiste en combinar múltiples modelos predictivos para mejorar la precisión, reducir errores y aumentar la robustez de las predicciones. Su objetivo principal es superar las limitaciones de los modelos individuales, especialmente cuando son [...]

Descenso del gradiente

Por |2025-02-18T20:11:58+01:00mayo 29th, 2022|

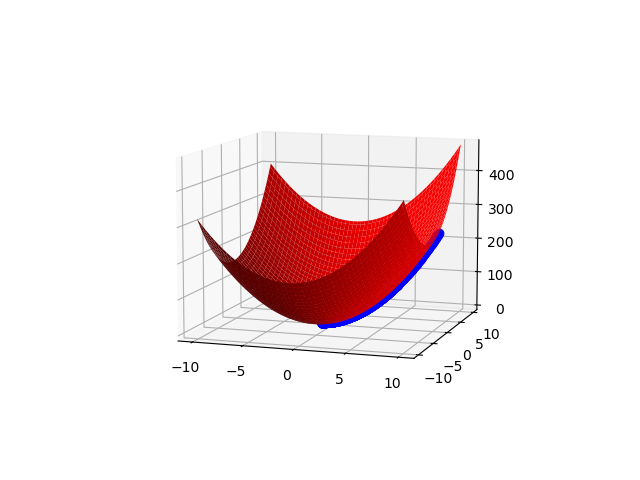
Introducción al descenso del gradiente El descenso del gradiente es un algoritmo de optimización utilizado en el aprendizaje automático y la inteligencia artificial. Su objetivo principal es encontrar los parámetros de un modelo que minimicen una función de coste o de error. Utiliza la derivación en funciones y se ajusta iterativamente en la [...]

Los k vecinos mas cercanos

Por |2025-01-27T20:43:11+01:00abril 22nd, 2022|

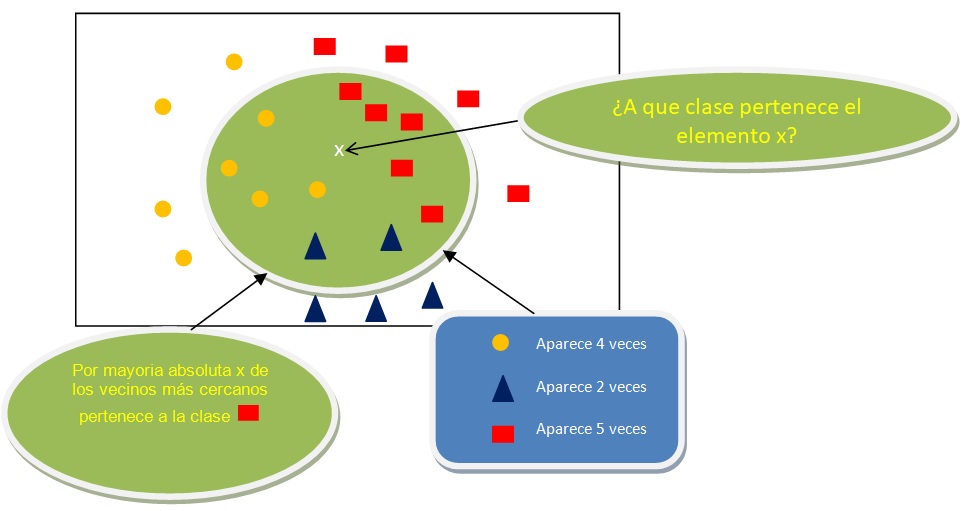
Los K vecinos mas cercanos es un clasificador de aprendizaje supervisado que usa la distancia de agrupaciones de datos para hacer clasificaciones o predicciones, por ejemplo en los problemas de clasificación, el algoritmo predice la etiqueta que mas se repite alrededor de un conjunto de datos. Para calcular las distancias a los puntos más [...]

Random forest

Por |2025-08-06T09:46:34+02:00abril 21st, 2022|

Random forest Random Forest es un algoritmo de aprendizaje automático basado en la combinación de múltiples árboles de decisión. Su objetivo es mejorar la precisión y reducir el sobreajuste mediante la creación de varios árboles y usando técnicas como el muestreo aleatorio y la selección aleatoria de características. En este artículo, exploraremos cómo [...]

¿Cómo implementar un arbol de decisiones? Guía paso a paso con ejemplo práctico

Por |2025-07-25T20:27:31+02:00abril 17th, 2022|

Para implementar un árbol de decisiones en machine learning, es esencial comenzar con la recolección y preprocesamiento de los datos, seleccionando las características clave para la tarea de clasificación. A continuación, se construye el modelo utilizando el algoritmo CART (Classification and Regression Trees), dividiendo los datos en nodos según reglas de decisión basadas en [...]

Impurezas en arboles de Decision: Índice Gini, Entropía y Error de Clasificación

Por |2025-01-24T18:30:13+01:00abril 17th, 2022|

Según las impurezas en arboles de decision, los árboles de decisión son algoritmos de machine learning ampliamente utilizados en problemas de clasificación y regresión. Sin embargo, para construir un árbol preciso, es fundamental elegir la mejor métrica de impureza que determine cómo dividir los datos en cada nodo. En este artículo, exploraremos los principales [...]

Árbol de Decisiones: Qué es, y cómo funciona

Por |2025-01-24T18:30:13+01:00abril 17th, 2022|

El arbol de decisiones es uno de los algoritmos más populares en aprendizaje automático debido a su simplicidad, interpretabilidad y eficacia. Se utiliza tanto para problemas de clasificación como de regresión, y su funcionamiento se basa en dividir los datos en subconjuntos más pequeños siguiendo criterios específicos, hasta llegar a resultados fácilmente interpretables. ¿Qué [...]

Truco del kernel

Por |2025-01-24T18:30:13+01:00abril 14th, 2022|

Cuando los datos no son linealmente separables, es necesario aplicar técnicas avanzadas para poder clasificarlos correctamente. En este caso, se pueden crear combinaciones no lineales de las características originales y proyectarlas en un espacio de mayor dimensión mediante una función de mapeo, utilizando el truco del kernel. Este concepto es esencial en el aprendizaje [...]

Las maquinas de soporte vectorial

Por |2025-01-24T18:30:13+01:00abril 10th, 2022|

Las Maquinas de Soporte Vectorial (SVM) son una técnica en aprendizaje automático diseñada para encontrar el hiperplano óptimo que separa diferentes clases en un conjunto de datos. Este hiperplano maximiza el margen de separación entre las clases, garantizando una clasificación más precisa y efectiva. Para que sirven las máquinas de soporte Las SVM son [...]

Modelo de regresión logística

Por |2025-01-24T18:30:13+01:00abril 3rd, 2022|

La regresión logística es uno de los algoritmos más utilizados en Machine Learning para resolver problemas de clasificación binaria. A continuación, exploraremos en detalle qué es, cómo funciona, sus ventajas, desventajas, cómo implementarla y los tipos de resultados que puede predecir. ¿Qué es la regresión logística? La regresión logística es [...]

Ir a Arriba