
Según las impurezas en arboles de decision, los árboles de decisión son algoritmos de machine learning ampliamente utilizados en problemas de clasificación y regresión. Sin embargo, para construir un árbol preciso, es fundamental elegir la mejor métrica de impureza que determine cómo dividir los datos en cada nodo. En este artículo, exploraremos los principales métodos de evaluación de impureza: Índice Gini, entropía y error de clasificación, explicando sus diferencias y cuándo utilizar cada uno.
¿Qué es las impurezas en arboles de decision?
Las impurezas en arboles de decision miden cuán homogéneas o heterogéneas son las clases dentro de un conjunto de datos en un nodo del árbol. Un nodo es puro si contiene únicamente ejemplos de una sola clase, mientras que la impureza aumenta si hay una mezcla de diferentes clases.
Existen varias métricas para medir la impureza en árboles de decisión, las más comunes son:
1. Índice Gini
La impureza de Gini mide como están mezcladas están las clases en un nodo. Se calcula como la suma de los cuadrados de las proporciones de cada clase en el nodo. Cuanto más cerca esté el valor de Gini de cero, más puro es el nodo donde todas las muestras pertenecen a la misma clase, y cuanto más cerca esté de uno, más impuro es decir las muestras están igualmente distribuidas en varias clases.
Su fórmula es:
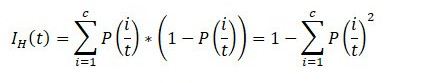
Ventajas del índice Gini:
- Rápido de calcular.
- No requiere logaritmos, lo que lo hace eficiente computacionalmente.
Desventajas:
- Puede no capturar con precisión la incertidumbre en la distribución de clases.
2. Entropía
Se calcula como la suma de las proporciones de cada clase multiplicada por el logaritmo de esas proporciones. Un nodo con entropía cero es completamente puro si todas las muestras pertenecen a la misma clase, mientras que un nodo con entropía más alta es más impuro y contiene una mezcla de clases, y es máxima si tenemos una distribución uniforme:
Se calcula con la fórmula:
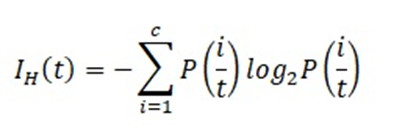
Un valor de entropía bajo indica nodos más homogéneos.
Ventajas de la entropía:
- Captura mejor la incertidumbre en la distribución de clases.
- Útil en conjuntos de datos más equilibrados.
Desventajas:
- Cálculo más costoso debido al uso de logaritmos.
3. Error de Clasificación
Es la proporción de muestras en el nodo que no pertenecen a la clase más común. Cuanto mayor sea el error de clasificación, más impuro será el nodo.
Su fórmula es:
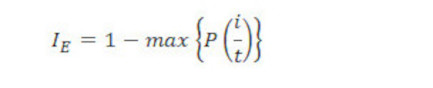
Ventajas:
- Fácil de interpretar.
- Útil para evaluaciones generales.
Desventajas:
- No es tan sensible a pequeñas mejoras en la pureza del nodo.
4.Ganancia de la información
La ganancia de información es una métrica utilizada en los árboles de decisión para medir la reducción de la impureza después de dividir un conjunto de datos según un atributo específico. Se basa en la diferencia entre la entropía antes y después de la división. Una ganancia de información alta indica que un atributo proporciona una partición más efectiva de los datos, ayudando a mejorar la precisión del modelo. Se prefiere en algoritmos como ID3, donde se selecciona el atributo con mayor ganancia para construir el árbol.
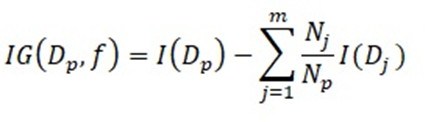
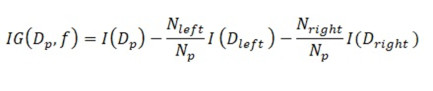
Comparación entre índice Gini, entropía y error de clasificación para las impurezas en arboles de decision
| Métrica | Precisión | Eficiencia computacional | Interpretación |
|---|---|---|---|
| Índice Gini | Alta | Alta | Moderada |
| Entropía | Muy alta | Media | Alta |
| Error de clasificación | Baja | Alta | Fácil |
¿Cuál métrica elegir para tu árbol de decisión?
- Índice Gini: Si buscamos velocidad y eficiencia en conjuntos de datos grandes.
- Entropía: Cuando deseamos evaluar con más detalle la incertidumbre del modelo.
- Error de clasificación: Para análisis rápidos y comprensibles, aunque menos precisos.
Conclusión
Elegir la métrica de impureza adecuada en un árbol de decisión es clave para mejorar la precisión y el rendimiento del modelo. El índice Gini y la entropía son los más utilizados, mientras que el error de clasificación se reserva para análisis más generales.