

Aprendizaje conjunto
¿Qué es el aprendizaje conjunto (Ensemble Learning)?
El aprendizaje conjunto es una técnica avanzada de machine learning que consiste en combinar múltiples modelos predictivos para mejorar la precisión, reducir errores y aumentar la robustez de las predicciones. Su objetivo principal es superar las limitaciones de los modelos individuales, especialmente cuando son débiles o tienen fortalezas complementarias.
Este enfoque se utiliza tanto en tareas de clasificación como de regresión, y es especialmente eficaz para mitigar el sobreajuste (overfitting) y mejorar la generalización en datos nuevos.
¿Por qué usar aprendizaje conjunto?
El ensemble learning ofrece múltiples ventajas clave:
- Mayor precisión predictiva
Aprovecha la combinación de múltiples modelos para generar predicciones más exactas. - Reducción del sobreajuste
Compensa los errores de modelos individuales, mejorando la capacidad de generalización. - Mayor robustez y estabilidad
Reduce la sensibilidad a datos ruidosos o atípicos. - Flexibilidad en la combinación de modelos
Permite integrar distintos algoritmos como árboles de decisión, SVM o regresión logística. - Adaptación a datos dinámicos
Mejora el rendimiento al incorporar datos nuevos de forma continua. - Reducción de sesgo y varianza
Genera modelos más equilibrados y predicciones más confiables. - Menor riesgo en decisiones críticas
Es útil en sectores como salud, finanzas o ciberseguridad, donde los errores pueden ser costosos.
¿Cómo se combinan los modelos en el aprendizaje conjunto?
La combinación de modelos en el aprendizaje conjunto se realiza mediante dos enfoques principales:
- Métodos basados en votos (voting)
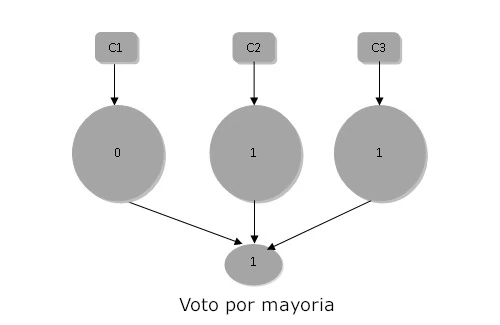
Utilizados especialmente en tareas de clasificación, consideran la decisión de cada modelo para determinar el resultado final.
- Voto por mayoría: La clase más votada por más del 50% de los modelos.
- Moda: Selecciona la clase más frecuente sin necesidad de mayoría.
- Unanimidad: Requiere que todos los modelos coincidan.
- Pluralidad: Gana la clase con más votos, aunque no alcance mayoría absoluta.
- Voto ponderado: Asigna más peso a modelos más confiables.
- Métodos basados en probabilidades
Ideales para tareas donde se necesita una medida de confianza. Combina probabilidades de cada clase predicha.
- Media de probabilidades: Promedia las predicciones de probabilidad.
- Media ponderada: Da más peso a los modelos más precisos.
- Voto por probabilidad acumulada: Selecciona la clase con mayor suma de probabilidades.
Principales técnicas de aprendizaje conjunto
Bagging (Bootstrap Aggregating)
Entrena varios modelos en subconjuntos aleatorios del conjunto de datos. Las predicciones se combinan promediando o por votación.
Ejemplo: RandomForestClassifier
Boosting
Entrena modelos secuencialmente, donde cada uno corrige los errores del anterior.
Ejemplos:
- AdaBoostClassifier
- GradientBoostingClassifier
Clases de Scikit-learn para aprendizaje conjunto
Scikit-learn ofrece implementaciones listas para usar que permiten combinar modelos fácilmente:
Clases basadas en votos
- VotingClassifier: Combina múltiples estimadores mediante voto duro o blando.
- MajorityVoteClassifier (implementación personalizada): Usa votación mayoritaria entre modelos base.
Clases basadas en probabilidades
- AdaBoostClassifier: Combina clasificadores débiles ajustando los errores iterativamente.
- GradientBoostingClassifier: Optimiza una función de pérdida mediante gradientes.
- RandomForestClassifier: Construye múltiples árboles en subconjuntos de datos.
Conclusión
El aprendizaje conjunto es una estrategia poderosa para mejorar el rendimiento en machine learning. Al combinar diferentes modelos, se logra mayor precisión, estabilidad y adaptabilidad frente a entornos complejos o datos cambiantes. Con herramientas como Scikit-learn, su implementación se vuelve accesible para una amplia gama de proyectos.


