
Los K vecinos mas cercanos es un clasificador de aprendizaje supervisado que usa la distancia de agrupaciones de datos para hacer clasificaciones o predicciones, por ejemplo en los problemas de clasificación, el algoritmo predice la etiqueta que mas se repite alrededor de un conjunto de datos.
Para calcular las distancias a los puntos más cercanos a nuestro punto x y ademas saber a la clase a la que pertenece vamos a usar dos tipos de distancias métricas la distancia euclidiana y la distancia de Manhattan.
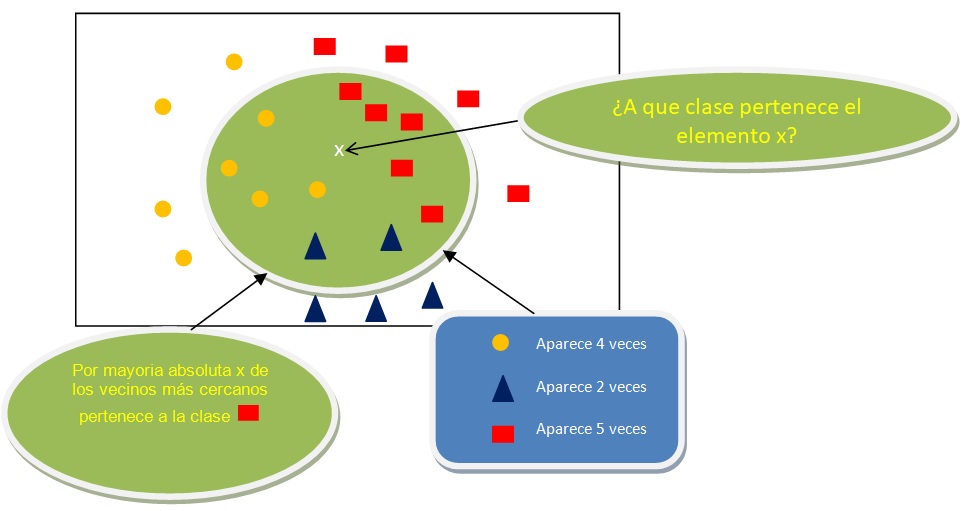
¿Cómo funciona el algoritmo KNN?
El proceso de clasificación con KNN consta de los siguientes pasos:
- Seleccionar un valor para K (número de vecinos más cercanos).
- Calcular la distancia entre la muestra y los datos de entrenamiento.
- Seleccionar los K vecinos más cercanos con base en la distancia calculada.
- Asignar una etiqueta de clase basada en la mayoría de votos entre los vecinos.
Aplicaciones del algoritmo KNN
KNN se utiliza en diversos campos, como:
- Reconocimiento de patrones: Clasificación de imágenes y textos.
- Preprocesamiento de datos: Limpieza y normalización de datos antes del análisis.
- Predicción de enfermedades: Diagnóstico médico basado en datos históricos.
- Economía: Análisis de tendencias y comportamientos financieros.
- Sistemas de recomendación: Recomendaciones de productos en e-commerce.
- Búsqueda de datos semánticos: Análisis de texto basado en similitud de contenido.
Tipos de distancias métricas en KNN
Para determinar los vecinos más cercanos, se pueden utilizar diferentes métricas de distancia:
Distancia euclidiana
Es la distancia entre dos puntos del espacio obtenida del teorema de Pitágoras, la cual es la distancia entre dos puntos P1 y P2 con coordenadas cartesianas:
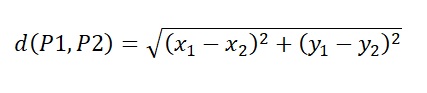
Distancia Manhattan
Se calcula como la suma de las diferencias absolutas de las coordenadas de dos puntos, representando la distancia “en línea recta”:
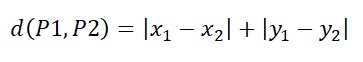
Es la distancia entre dos puntos del espacio, la cual es la distancia entre dos puntos P1 y P2 cuya suma son las longitudes de los catetos de un triangulo rectángulo.
- Elegimos un numero k y una distancia x
- Encontramos los k vecinos mas cercanos a nuestra muestra que queremos clasificar
- Asignamos la etiqueta de clase por mayoría de votos.
Si tenemos una muestra, el algoritmo de los kvecinos en los datos de entrenamiento encuentra las k muestras alrededor que estén a menos de una distancia x y luego al predecir la etiqueta de clase nuestra muestra se va a ser predicha por mayoría de votos entre las k muestras mas cercanas.
Ejemplo de implementación de KNN en Python
from sklearn import datasets
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.metrics import confusion_matrix, accuracy_score
from sklearn.neighbors import KNeighborsClassifier

def getDatos():
iris = datasets.load_iris()
X = iris.data[:, [2, 3]]
Y = iris.target
return X, Y

def divisionDatos(X, Y):
X_train, X_test, y_train, y_test = train_test_split(
X, Y, test_size=0.3, random_state=1, stratify=Y)
return X_train, X_test, y_train, y_test

def getMetricas(Y_predic, Y_test):
print("Número de datos mal clasificados:")
print((Y_predic != Y_test).sum())
exactitud = accuracy_score(Y_test, Y_predic)
print("Exactitud del modelo:", exactitud)
print('Matriz de confusión:\n', confusion_matrix(Y_test, Y_predic))

def normalizacion(X_train, X_test):
normalizar = StandardScaler()
X_train_std = normalizar.fit_transform(X_train)
X_test_std = normalizar.transform(X_test)
return X_train_std, X_test_std

X, Y = getDatos()
X_train, X_test, y_train, y_test = divisionDatos(X, Y)
X_train_std, X_test_std = normalizacion(X_train, X_test)

kvecinos = KNeighborsClassifier(n_neighbors=10, p=2)
kvecinos.fit(X_train_std, y_train)
y_predict = kvecinos.predict(X_test_std)

getMetricas(y_predict, y_test)
Numero de datos mal clasificados:
1
Exactitud del modelo:
0.9777777777777777
La matriz de confusion es:
[[15  0  0]
 [ 0 15  0]
 [ 0  1 14]]
En este ejemplo, se entrenan y evalúan los datos del conjunto Iris utilizando KNeighborsClassifier, donde los parámetros principales son:
- n_neighbors: Número de vecinos cercanos a considerar.
- p: Define la métrica de distancia (1 para Manhattan, 2 para Euclidiana, otros valores para Minkowski).
Conclusión
El algoritmo de K-Vecinos Más Cercanos (KNN) es una herramienta poderosa para la clasificación de datos basada en la proximidad. Su simplicidad y efectividad lo hacen ideal para aplicaciones en diversos campos, aunque su rendimiento puede verse afectado por el tamaño de los datos.