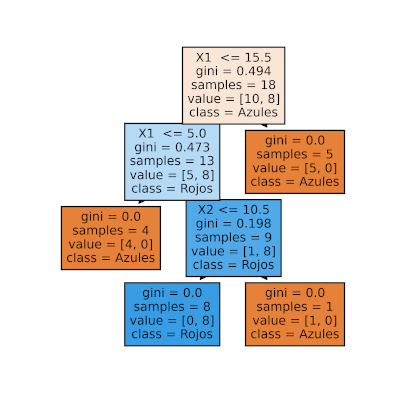
Para implementar un árbol de decisiones en machine learning, es esencial comenzar con la recolección y preprocesamiento de los datos, seleccionando las características clave para la tarea de clasificación. A continuación, se construye el modelo utilizando el algoritmo CART (Classification and Regression Trees), dividiendo los datos en nodos según reglas de decisión basadas en los atributos más informativos.
Una vez entrenado, se evalúa el rendimiento del árbol de decisiones mediante métricas como la precisión, la recall o el F1-score. Para evitar el sobreajuste y mejorar su generalización, es recomendable aplicar técnicas de poda (pruning), eliminando ramas que aportan poca o ninguna mejora al modelo.
Pasos para implementar un arbol de Decisiones
- Definir el problema:
- Identifica el objetivo que deseas alcanzar con el árbol de decisiones, como clasificar clientes o predecir resultados.
- Recopilación de datos:
- Obtén los datos relevantes que servirán de base para entrenar el modelo.
- Preprocesamiento de datos:
- Limpia los datos, eliminando valores nulos e irrelevantes.
- Convierte datos categóricos en numéricos si es necesario.
- Selección de la métrica de división:
- Utiliza métricas como la ganancia de información o el índice Gini para dividir los nodos del árbol.
- Construcción del árbol:
- Aplicar algoritmos como ID3, C4.5 o CART para dividir los datos en ramas basadas en condiciones lógicas.
- Poda del árbol:
- Reduce la complejidad del árbol eliminando ramas irrelevantes o redundantes.
- Evaluación del modelo:
- Usa métricas como precisión, recall y la matriz de confusión para medir su rendimiento.
Ejemplo práctico de un Árbol de Decisiones en Python
A continuación, se muestra un ejemplo de implementación utilizando la librería sklearn de Python:
Si tenemos el tenemos el siguiente conjunto de datos:
| X0 | X1 | Y |
| 1 | 3 | 0 |
| 1 | 9 | 0 |
| 3 | 5 | 0 |
| 3 | 9 | 0 |
| 9 | 12 | 0 |
| 16 | 9 | 0 |
| 16 | 12 | 0 |
| 18 | 8 | 0 |
| 18 | 3 | 0 |
| 20 | 5 | 0 |
| 7 | 3 | 1 |
| 7 | 6 | 1 |
| 7 | 9 | 1 |
| 10 | 4 | 1 |
| 10 | 8 | 1 |
| 12 | 2 | 1 |
| 15 | 2 | 1 |
| 15 | 7 | 1 |
Realizamos los siguientes pasos antes de implementar el algoritmo:
- Instalamos pyparsing:
- pip3 install pyparsing
- Importamos la librerías:
- from sklearn import tree
- from sklearn.tree import DecisionTreeClassifier
import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets
from matplotlib.colors import ListedColormap
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.metrics import confusion_matrix
from sklearn.metrics import accuracy_score
from sklearn.svm import SVC
from sklearn import tree
from sklearn.tree import DecisionTreeClassifier

from sklearn.preprocessing import LabelEncoder
import pandas as pd
def getDatos():
    #Lectura de datos
    datos = pd.read_csv("datos.csv")
    X=datos.iloc[0:,:2].values
    Y=datos.iloc[0:,2].values
    return X,Y

def divisionDatos(X, Y):
    X_train, X_test, y_train, y_test = train_test_split(
    X, Y, test_size=0.3, random_state=1, stratify=Y)
    return X_train, X_test, y_train, y_test

def getMetricas(Y_predic,Y_test):
    print("Numero de datos mal clasificados: ")
    print((Y_predic != Y_test).sum())
    exactitud = accuracy_score(Y_test,Y_predic)
    print("Exactitud del modelo:")
    print(exactitud)
    print('La matriz de confusion es: ')
    print(confusion_matrix(Y_test,Y_predic))
def normalizacion(X_train,X_test):
    #Normalizamos los datos
    normalizar = StandardScaler()
    X_train_std = normalizar.fit_transform(X_train)
    X_test_std = normalizar.transform(X_test)
    return X_train_std, X_test_std

X,Y = getDatos()

arbolDecision = DecisionTreeClassifier(criterion='gini',
                              max_depth=4,
                              random_state=1)

arbolDecision.fit(X,Y)

nombres_caracteristicas=['X1 ','X2']
nombre_clases=['Azules', 'Rojos']
fig, axes = plt.subplots(nrows = 1,ncols = 1,figsize = (4,4), dpi=300)
tree.plot_tree(arbolDecision,
               feature_names = nombres_caracteristicas,
               class_names=nombre_clases,
               filled = True);
fig.savefig('tree.png')
Descripción del código
Este código implementa un Árbol de Decisiones utilizando la biblioteca sklearn en Python para clasificar datos de un archivo CSV. A continuación, se explican las funciones principales y su propósito:
getDatos()- Carga los datos desde el archivo
datos.csv, extrayendo las dos primeras columnas como variables de entrada (X) y la tercera columna como la variable objetivo (Y). - Devuelve los datos en formato de arrays NumPy para su posterior procesamiento.
- Carga los datos desde el archivo
divisionDatos(X, Y)- Divide los datos en conjuntos de entrenamiento y prueba utilizando la función
train_test_split. - Se reserva el 30% de los datos para prueba, asegurando una distribución balanceada con la opción
stratify. - Devuelve los conjuntos de datos de entrenamiento y prueba.
- Divide los datos en conjuntos de entrenamiento y prueba utilizando la función
getMetricas(Y_predic, Y_test)- Evalúa el rendimiento del modelo comparando las predicciones con los valores reales.
- Muestra el número de clasificaciones incorrectas, la exactitud del modelo y la matriz de confusión, que proporciona un resumen del desempeño.
normalizacion(X_train, X_test)- Estandariza los datos para que tengan media 0 y desviación estándar 1, mejorando el rendimiento del modelo.
- Devuelve los datos normalizados para el conjunto de entrenamiento y prueba.
Flujo general del código:
- Se cargan los datos utilizando
getDatos(). - Se entrena un Árbol de Decisiones con los datos completos mediante
DecisionTreeClassifier, configurado con el criterio de índice Gini y una profundidad máxima de 4. - Se visualiza el árbol entrenado con
tree.plot_tree(), incluyendo los nombres de las características y clases. - Finalmente, la imagen generada se guarda como
tree.png.
Este enfoque permite comprender cómo implementar un árbol de decisiones, desde la carga de datos hasta la evaluación y visualización del modelo, facilitando su uso en problemas de clasificación.