

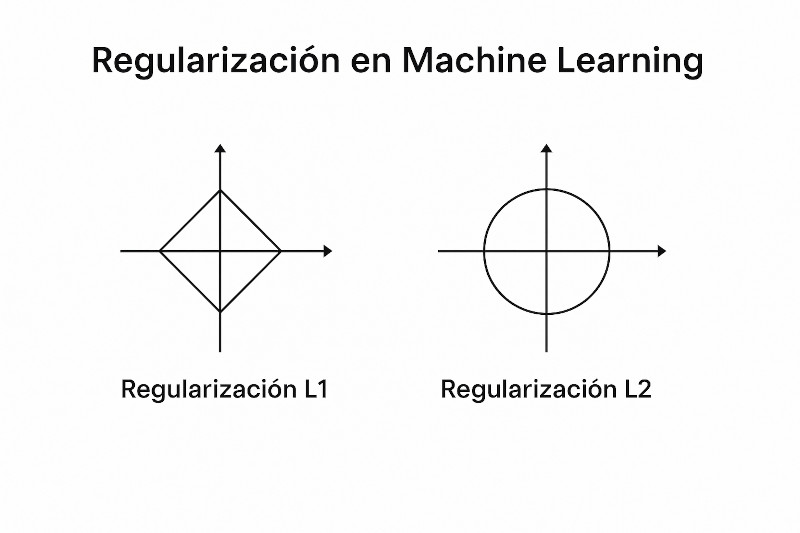
Regularizacion en Machine Learning: conceptos, técnicas y cómo aplicarla
Regularizacion en Machine Learning: Cuando entrenamos modelos de machine learning, buscamos que estos generalicen bien para que funcionen correctamente con datos nuevos. Sin embargo, a menudo nos enfrentamos a problemas como el sobreajuste (overfitting).
Aquí es donde entra en juego la regularización en machine learning, una técnica esencial para controlar la complejidad de los modelos y mejorar su rendimiento.
¿Qué es la regularizacion en machine learning?
La regularización en machine learning es una técnica que añade una penalización al modelo para evitar que se ajuste demasiado a los datos de entrenamiento. Esta penalización ayuda a reducir la complejidad del modelo y mejora su capacidad de generalización, evitando que memorice datos irrelevantes o ruido.
¿Qué es normalizar en machine learning?
Antes de aplicar la regularización, es fundamental normalizar los datos. Normalizar significa escalar los valores numéricos para que todas las características tengan un rango similar.
Esto es importante porque la regularización penaliza los coeficientes del modelo, y si las variables tienen escalas diferentes, unas podrían tener más peso que otras injustamente.
¿Qué es la regularizacion en machine learning L1 y L2?
Las dos técnicas de regularización más comunes son:
- Regularización L1 (Lasso):
Esta técnica agrega una penalización basada en el valor absoluto de los coeficientes. Una característica clave de L1 es que puede llevar algunos coeficientes a cero, ayudando en la selección automática de variables. - Regularización L2 (Ridge):
Utiliza una penalización basada en el cuadrado de los coeficientes. L2 no elimina variables, pero reduce el impacto de aquellas que tienen menos relevancia.
Ambas buscan evitar que el modelo sea demasiado complejo, pero L1 es útil cuando también quieres simplificar el modelo eliminando variables.

¿Qué son las técnicas de regularización?
Además de L1 y L2, existen otras técnicas de regularización que puedes considerar:
- ElasticNet: Combina L1 y L2 para obtener los beneficios de ambas.
- Dropout (en redes neuronales): Desactiva aleatoriamente algunas neuronas durante el entrenamiento para evitar que el modelo dependa demasiado de rutas específicas.
- Early Stopping: Detiene el entrenamiento cuando el modelo empieza a sobreajustarse.
¿Cómo se implementa la regularización?
La implementación de la regularización depende de la librería que utilices. En scikit-learn, por ejemplo, puedes activar fácilmente la regularización L1 o L2 cuando creas tu modelo.
from sklearn.linear_model import LogisticRegression

# Regularización L2 (Ridge)
modelo = LogisticRegression(penalty='l2', C=1.0)

# Regularización L1 (Lasso)
modelo = LogisticRegression(penalty='l1', solver='liblinear', C=1.0)
El parámetro C controla la fuerza de la regularización: cuanto más pequeño es C, mayor es la penalización.
El siguiente código en Python implementa un ejemplo práctico de regularización en machine learning utilizando la regresión logística con penalización L1 (Lasso) sobre el conjunto de datos de vinos (wine dataset).
Se comienza con la preparación de los datos, cargando el archivo CSV, separando las características y etiquetas, y dividiendo el conjunto de datos en entrenamiento y prueba.
Después, se aplica la normalización para asegurar que todas las variables tengan la misma escala antes de entrenar el modelo.
A continuación, se entrena una regresión logística variando el valor del hiperparámetro C, que controla la intensidad de la regularización. El modelo se ajusta usando diferentes valores de C para analizar cómo afecta la precisión del modelo tanto en el conjunto de entrenamiento como en el de prueba.
Finalmente, el código genera una curva de validación, mostrando cómo cambia la precisión según el valor de C, ayudando a identificar el equilibrio ideal entre underfitting y overfitting.
Esta visualización es clave para comprender el impacto de la regularización y seleccionar correctamente el hiperparámetro que ofrece el mejor rendimiento para el modelo.
from numpy import arange
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
import matplotlib.pyplot as plt
from sklearn.metrics import accuracy_score
import numpy as np
def getDatos():
    wine = pd.read_csv("wine.csv")
    nombres_columns= wine.columns.values
    X = wine.iloc[:, 1:].values
    Y = wine.iloc[:, 0].values
    return X,Y,nombres_columns
def divisionDatos(X,Y):
    X_train, X_test, y_train, y_test = train_test_split(
    X, Y, test_size=0.3, random_state=1, stratify=Y)
    return X_train, X_test, y_train, y_test
def normalizar(X_train,X_test):
    normalizar = StandardScaler()
    X_train_std = normalizar.fit_transform(X_train)
    X_test_std = normalizar.transform(X_test)
    return X_train_std,X_test_std
X,Y,nombres_columns = getDatos()
X_train, X_test, y_train, y_test = divisionDatos(X,Y)
X_train_std,X_test_std = normalizar(X_train,X_test)
def regresionLogistica(c,X_train_std,X_test_std,y_train,y_test):
    lr = LogisticRegression(penalty='l1',solver='liblinear',C=10.**c, random_state=1,multi_class='ovr')
    lr.fit(X_train_std, y_train)
    precision_train = lr.score(X_train_std,y_train)
    precision_test= lr.score(X_test_std,y_test)
    W=lr.coef_
    intercepcion = lr.intercept_
    return precision_train,precision_test,W,intercepcion

def curvaValidacion(array_parametros,array_precision_train,array_precision_test):
    plt.plot(array_parametros,array_precision_train,color='blue',linestyle='--',marker='s',markersize=5,label='Precision de entrenamiento')
    plt.plot(array_parametros,array_precision_test,color='green',linestyle='--',marker='o',markersize=5,label='Precision de test')
    plt.grid()
    plt.xscale('log')
    plt.legend(loc='lower right')
    plt.xlabel('Parametro C')
    plt.ylabel('Precision')
    plt.xlim([10**(-4), 10**5])
    plt.ylim([0.0,1.25])
    plt.show()
array_parametros = []
array_precision_train=[]
array_precision_test =[]
for c in arange(-4,10):
    precision_train,precision_test,w,intercepcion=regresionLogistica(c,X_train_std,X_test_std,y_train,y_test)
    array_precision_train.append(precision_train)
    array_precision_test.append(precision_test)
    array_parametros.append(10.**c)
    if (10.**c== 0.1):
        print("Los valores para ", 10.**c ,  " de w son:", w)
        print("Precision de entrenamiento: ",precision_train)
        print("Precision de test: ",precision_test)
curvaValidacion(array_parametros,array_precision_train,array_precision_test)
En el ejemplo anterior, cuando se utilizan valores de C menores a 10⁻¹, la regularización en machine learning se incrementa, haciendo que el modelo sea más restrictivo. Como consecuencia, el modelo se vuelve más simple y flexible, lo que puede provocar underfitting o subajuste. En este caso, el modelo no logra ajustarse correctamente a los datos de entrenamiento, perdiendo la capacidad de capturar patrones importantes o características clave dentro del conjunto de datos.
Por el contrario, si seleccionamos un valor de C mayor a 10⁻¹, la regularización disminuye, permitiendo que el modelo se vuelva más complejo. Este aumento en la complejidad puede mejorar el ajuste a los datos de entrenamiento, pero también incrementa el riesgo de sufrir overfitting o sobreajuste. En esta situación, el modelo podría memorizar demasiado los datos de entrenamiento, lo que afectaría negativamente su capacidad para generalizar correctamente cuando se enfrente a nuevos datos no vistos.
¿Cuáles son los pasos para aplicar la regularización?
- Preparación de los datos
Primero, es fundamental limpiar y preprocesar los datos. Se eliminan errores, valores nulos o atípicos, y se divide el conjunto en datos de entrenamiento y de prueba para asegurar una correcta evaluación del modelo. - Selección del modelo
Elegimos el modelo de machine learning que mejor se adapte al tipo de datos y al problema que queremos resolver. Por ejemplo, modelos de regresión, árboles de decisión o redes neuronales. - Entrenamiento del modelo
Entrenamos el modelo para que aprenda los patrones y relaciones presentes en los datos de entrenamiento, mejorando su capacidad predictiva. - Aplicación de la regularización
Integramos la regularización L1 o L2, seleccionando también el valor óptimo del hiperparámetro C. Esto ayuda a prevenir el sobreajuste y a mejorar la generalización del modelo. - Evaluación del modelo
Medimos el rendimiento del modelo utilizando los datos de prueba. Calculamos métricas clave como la precisión, la exactitud o la puntuación F1, que nos indican qué tan bien predice el modelo. - Ajuste de hiperparámetros
Optimizamos los hiperparámetros mediante técnicas como la validación cruzada y búsqueda de cuadrícula (Grid Search), afinando el valor de la regularización y otros parámetros clave para lograr los mejores resultados. - Validación del modelo
Realizamos una validación cruzada para asegurar que el modelo funcione correctamente con datos no vistos y que mantenga su capacidad de generalización. - Implementación del modelo en producción
Una vez validado, el modelo se implementa en un entorno de producción para que pueda realizar predicciones reales con nuevos datos que no ha visto previamente. - Monitoreo y mejora continua del modelo
Supervisamos constantemente el rendimiento del modelo en producción, actualizando los datos de entrenamiento y ajustando los hiperparámetros si es necesario para mantener un alto nivel de precisión y eficiencia.
¿Como vamos a seleccionar un hiperparámetro de la regularización?
La elección del hiperparámetro de regularización (C en scikit-learn) es clave para el éxito del modelo.
La mejor práctica es utilizar técnicas como:
- GridSearchCV: Prueba múltiples valores de C para encontrar el óptimo.
- Curvas de validación: Analiza cómo cambia la precisión del modelo según el valor de C.
- Validación cruzada: Evalúa el rendimiento en diferentes particiones del conjunto de datos.
Así, seleccionamos el valor de regularización que consigue el mejor equilibrio entre sesgo y varianza.
Conclusión
La regularización en machine learning es una herramienta poderosa para construir modelos robustos y evitar el sobreajuste. Ya sea que elijas L1, L2 o una combinación de ambas, lo importante es seguir un proceso ordenado: normalizar los datos, seleccionar bien la técnica de regularización, y ajustar los hiperparámetros mediante validación cruzada.
Aplica estas prácticas y mejora significativamente la capacidad predictiva de tus modelos.


