


¿Qué son las curvas ROC?
Las curvas ROC (Receiver Operating Characteristic) son una representación gráfica fundamental para evaluar el rendimiento de un modelo de clasificación binaria. Muestra cómo varían la sensibilidad y la especificidad del modelo al modificar los umbrales de decisión de los scores de predicción.
Esta curva se construye a partir de dos métricas clave:
- Tasa de verdaderos positivos (TPR): también conocida como sensibilidad, indica la proporción de positivos correctamente clasificados.
- Tasa de falsos positivos (FPR): muestra cuántos negativos han sido incorrectamente clasificados como positivos.
Por ejemplo, en un sistema de detección de spam en correos electrónicos, un verdadero positivo sería clasificar correctamente un correo no deseado como spam, mientras que un falso positivo sería marcar erróneamente un correo legítimo como spam.
¿Qué indica el AUC de una curva ROC?
El valor del AUC (Área Bajo la Curva ROC) indica qué tan bien un modelo de clasificación binaria es capaz de distinguir entre clases positivas y negativas. Dependiendo del rendimiento del modelo, el AUC puede tomar los siguientes valores:
- AUC = 1: El modelo es perfecto, clasifica correctamente todas las instancias positivas y negativas sin errores.
- AUC > 0.5: El modelo es mejor que el azar, tiene una capacidad significativa para diferenciar entre clases.
- AUC = 0.5: El modelo tiene un comportamiento similar al azar, sin capacidad real de clasificación.
- AUC < 0.5: El modelo es peor que el azar, clasifica incorrectamente con más frecuencia de lo esperado.
Matriz de confusión y curva ROC
Cada predicción realizada por el modelo genera un punto en el espacio de la curva ROC, en función de los valores de sensibilidad (TPR) y especificidad (1 – FPR). Los extremos más representativos son:
- Punto (1, 0): No hay falsos negativos (sensibilidad = 1) ni falsos positivos (especificidad = 1). Es el punto ideal.
- Punto (0, 1): Todos los resultados son clasificados erróneamente (sensibilidad = 0, especificidad = 0), lo que indica un modelo completamente ineficaz.

Tenemos tres puntos A, B, y C, de los cuales el A es el mejor es que se acerca a la clasificacion perfecta, el B se encuentra al 50% entre la sensibilidad y la especificidad y el C es que peor resultado tiene.
Scores y umbrales de decisión
¿Qué son los scores?
Los scores (también llamados probabilidades o salidas del modelo) son los valores que el modelo devuelve antes de tomar una decisión final.
Ejemplo sencillo con un modelo de detección de spam:
scores = [0.9, 0.8, 0.6, 0.4, 0.2]
Estos valores indican la probabilidad de que un correo sea spam.
¿Qué es el umbral?
Es el valor que se usa para convertir un score en una clase:
- Si score ≥ umbral → clase 1
- Si score < umbral → clase 0
Por defecto, los modelos suelen usar 0.5 como umbral, pero esto se puede ajustar para mejorar el rendimiento según el problema.
Ejemplo comparativo de umbral:
| Correo | Score | Umbral 0.5 | Umbral 0.7 |
| A | 0.9 | Spam | Spam |
| B | 0.6 | Spam | No Spam |
| C | 0.4 | No Spam | No Spam |
Con umbral 0.5: casi todos se predicen como spam y con un umbral es más estricto, y algunos correos ya no se consideran spam.
Importancia de ajustar el umbral:
- Reducir falsos positivos (marcar correos buenos como spam).
- Mejorar la sensibilidad o especificidad, según el objetivo del modelo.
- Generar curvas ROC y encontrar el equilibrio entre precisión y recall.
Ejemplo 1: Curva ROC en Python
El siguiente código genera y visualiza una curva ROC (Receiver Operating Characteristic) a partir de un conjunto de etiquetas verdaderas (y) y puntuaciones de predicción (scores) para un problema de clasificación binaria.
Breve descripción paso a paso:
-
Importa librerías necesarias:
NumPy,sklearn.metricsymatplotlib.pyplot. -
Define las etiquetas verdaderas (
y) y los scores de predicción del modelo (scores). -
Calcula la tasa de verdaderos positivos (TPR) y tasa de falsos positivos (FPR) usando
metrics.roc_curve(). -
Imprime los valores de TPR y FPR.
-
Grafica la curva ROC, mostrando cómo varían TPR y FPR al cambiar el umbral de decisión.
Esta curva es útil para evaluar la capacidad de un modelo para distinguir entre clases positivas y negativas.
import numpy as np
from sklearn import metrics
import matplotlib.pyplot as plt
y = np.array([1,1,0,1,0,1,0,0,0,0])
scores = np.array([0.93,0.97,0.70,0.60,0.5,0.37,0.33,0.28,0.11,0.01])
fpr, tpr, thresholds = metrics.roc_curve(y, scores, pos_label=None)
print('Los valores tpr son:',tpr)
print('Los valores fpr son:',fpr)
plt.plot(fpr,tpr)
plt.show()
0.33333333 1. ]

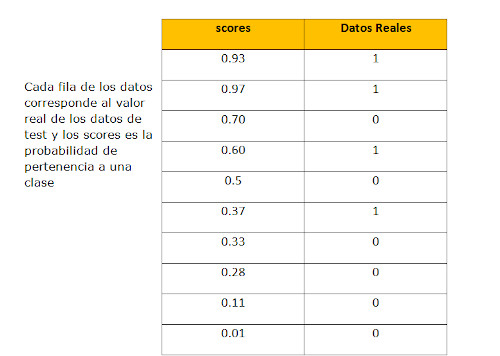
Interpretación
Las imágenes anteriores ilustran cómo se construye una curva ROC a partir de los valores reales de un conjunto de datos de prueba y las probabilidades (scores) de predicción generadas por un modelo de clasificación binaria.
Imagen 1 – Gráfico de la curva ROC
Esta gráfica muestra la relación entre la Tasa de Falsos Positivos (FPR) y la Tasa de Verdaderos Positivos (TPR) para distintos umbrales de decisión aplicados a los scores. Es una herramienta fundamental para evaluar la capacidad del modelo para distinguir entre las clases positivas (1) y negativas (0).
- El eje X representa la FPR (falsos positivos sobre todos los negativos).
- El eje Y representa la TPR (verdaderos positivos sobre todos los positivos).
- Una curva más próxima al vértice superior izquierdo indica un mejor rendimiento del modelo.
Imagen 2 – Tabla de datos reales y scores
Esta tabla contiene:
- La columna “scores”: valores de probabilidad que el modelo asignó a cada muestra para pertenecer a la clase positiva.
- La columna “Datos Reales”: etiquetas reales (0 o 1) de las muestras.
- El texto indica que cada fila representa una instancia de prueba, donde se comparan los resultados del modelo con la realidad.
Relación entre ambas imágenes
La curva ROC de la primera imagen se construye usando los valores de la tabla de la segunda imagen. Al modificar el umbral de clasificación sobre los scores, se generan diferentes combinaciones de TPR y FPR, que luego se representan gráficamente.
Esto permite visualizar cómo de bien el modelo diferencia entre clases a distintos niveles de sensibilidad.
Ejemplo 2: Regresión logística con curva ROC
El siguiente código realiza un ejemplo completo de clasificación binaria usando regresión logística con el dataset de Iris de scikit-learn, centrándose en dos clases:
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn import datasets
from sklearn.preprocessing import LabelEncoder
from sklearn.metrics import roc_curve
from sklearn.metrics import auc
import matplotlib.pyplot as plt
from sklearn.metrics import confusion_matrix
from sklearn.metrics import accuracy_score
def getDatos():
    iris = datasets.load_iris()
    X= iris.data[50:,[1,2]]
    Y = iris.target[50:] #clases 1 y 2
    return X,Y
def transformacionEtiquetas(Y):
    labelEncoder = LabelEncoder()
    y = labelEncoder.fit_transform(Y)
    return y
def divisionDatos(X,Y):
    X_train, X_test, y_train, y_test = train_test_split(X, Y,
                     test_size=0.20,
                     stratify=Y,
                     random_state=42)
    return X_train, X_test, y_train, y_test
def regresionLogistica():
    lr = LogisticRegression(penalty='l2',random_state=1)
    return lr

def curvaROC(y_test,probabilidadesClase):
    fpr, tpr, thresholds = roc_curve(y_true=y_test,
                                        y_score=probabilidadesClase)

    roc_auc = auc(x=fpr, y=tpr)
    plt.plot(fpr, tpr,
                    color='blue',
                    linestyle='--',
                    label='%s (area = %0.2f)' % ("Regresion Logistica", roc_auc))
    plt.plot([0,1],
             [0,1],
             linestyle='--',
             color=(0.6,0.6,0.6),
             )
    plt.xlabel('Ratio de los falsos positivos')
    plt.ylabel('Ratio de los verdaderos positivos')
    plt.legend(loc="lower right")
    plt.show()
X,Y = getDatos();
Y = transformacionEtiquetas(Y)
X_train, X_test, y_train, y_test=divisionDatos(X,Y)
lr=regresionLogistica()
lr.fit(X_train, y_train)
probabilidadesClase0 = lr.predict_proba(X_test)[:, 0]
probabilidadesClase1 = lr.predict_proba(X_test)[:, 1]
y_predict = lr.predict(X_test)
curvaROC(y_test,probabilidadesClase1)
lr.fit(X_train,y_train)
y_predic=lr.predict(X_test)
print('La matriz de confusion de LR es: ')
print(confusion_matrix(y_test,y_predic))
score = accuracy_score(y_test, y_predic)
print("Score: ",score)
La matriz de confusion de LR es:
[[9 1]
 [2 8]]
Score:  0.85
ProbabilidadesClase1	y_test
0.99208874	1
0.49339161	1
0.58597283	1
0.66442661	1
0.00391281	0
0.01069825	0
0.40518389	0
0.97758593	1
0.20271637	0
0.5001832	0
0.04212071	0
0.95771891	1
0.05795204	0
0.05736161	0
0.0079656	0
0.96859223	1
0.58992191	1
0.19663851	0
0.20009457	1
0.91845685	1
Para los diferentes puntos de corte de obtiene la siguiente tabla:
FPR	TPR
0.	0.
0.	0.1
0.	0.8
0.1	0.8
0.1	0.9
0.3	0.9
0.3	1.
1.	1.
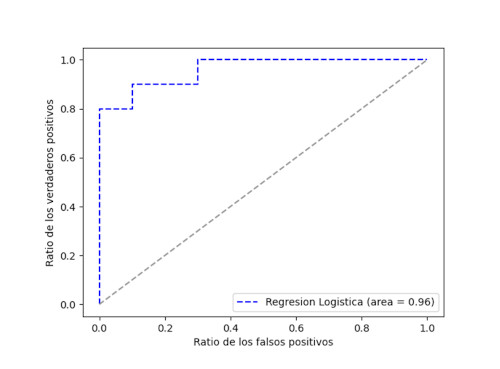
La imagen muestra una curva ROC (Receiver Operating Characteristic) que evalúa el rendimiento de un modelo de Regresión Logística en una tarea de clasificación binaria.
Descripción breve:
-
Ejes:
-
Eje X: Ratio de falsos positivos (FPR).
-
Eje Y: Ratio de verdaderos positivos (TPR).
-
-
Curva azul discontinua:
-
Representa el desempeño del modelo. La curva muestra una alta sensibilidad con baja tasa de falsos positivos.
-
-
Línea gris diagonal:
-
Representa el rendimiento de un modelo aleatorio (AUC = 0.5). Cualquier modelo útil debe estar por encima de esta línea.
-
-
Área bajo la curva (AUC = 0.96):
-
Indica una excelente capacidad de discriminación del modelo, ya que se acerca al valor ideal de 1.
-
Conclusión:
El modelo de regresión logística tiene un alto rendimiento predictivo, con una buena capacidad para diferenciar correctamente entre las dos clases.
Ejemplo 3: Curva ROC con validación cruzada
El siguiente código en Python implementa y evalúa un modelo de regresión logística sobre el dataset de Iris usando curvas ROC con validación cruzada estratificada. A continuación, te describo sus partes y funcionamiento en menos de 10 líneas:
Descripción del código en 10 puntos clave:
-
Carga del dataset Iris limitado a 2 clases (
setosayversicolor) y 2 características (longitud del sépaloylongitud del pétalo). -
Se codifican las etiquetas (Label Encoding) y se dividen los datos en entrenamiento y prueba.
-
Se construye un pipeline que incluye escalado de características (StandardScaler), reducción de dimensionalidad con PCA y una regresión logística.
-
Se define una función
ROC_AUCque entrena el modelo usando validación cruzada con 3 pliegues (StratifiedKFold). -
En cada pliegue, se calcula la curva ROC y el AUC (área bajo la curva), usando las probabilidades predichas.
-
Se interpola la curva TPR sobre una FPR común para permitir el cálculo del promedio.
-
Se dibujan las curvas ROC individuales de cada pliegue junto con una línea base (clasificación aleatoria).
-
Se calcula y representa la curva ROC promedio con su AUC correspondiente.
-
Se etiquetan los ejes con la tasa de falsos positivos y verdaderos positivos.
-
Se muestra la gráfica final que resume el rendimiento medio del modelo en clasificación binaria.
import pandas as pd
from sklearn.preprocessing import LabelEncoder
from sklearn.model_selection import train_test_split
from sklearn.metrics import roc_curve, auc
from scipy import interp
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import StratifiedKFold
import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets
def getDatos():
    datos = datasets.load_iris()
    X = datos.data[:100, [0, 2]]
    Y = datos.target[:100]
    return X, Y

def transformacionEtiquetas(Y):
    labelEncoder = LabelEncoder()
    y = labelEncoder.fit_transform(Y)
    return y

def divisionDatos(X, Y):
    X_train, X_test, y_train, y_test = train_test_split(X, Y,
                                                        test_size=0.20,
                                                        stratify=Y,
                                                        random_state=1)
    return X_train, X_test, y_train, y_test

def get_pipeline():
    nuevo_pipeline = make_pipeline(StandardScaler(),
                                   PCA(n_components=2),
                                   LogisticRegression(penalty='l2',
                                                      random_state=1,
                                                      C=100.0))
    return nuevo_pipeline
def ROC_AUC(X_train, y_train):
    mean_tpr = 0.0
    mean_fpr = np.linspace(0, 1, 100)
    pipe_lr = get_pipeline()

    # Entrenamos y evaluamos el modelo utilizando validación cruzada
    cv = StratifiedKFold(n_splits=3, random_state=None)
    for i, (train, test) in enumerate(cv.split(X_train, y_train)):
        pipe_lr.fit(X_train[train], y_train[train])
        probas_pertenencia = pipe_lr.predict_proba(X_train[test])
        fpr, tpr, thresholds = roc_curve(y_train[test], probas_pertenencia[:, 1], pos_label=1)
        mean_tpr += np.interp(mean_fpr, fpr, tpr)
        mean_tpr[0] = 0.0
        roc_auc = auc(fpr, tpr)
        plt.plot(fpr, tpr, lw=1, label='ROC pliege %d (AUC = %0.2f)' % (i+1, roc_auc))

    # Graficamos la línea diagonal (clasificación aleatoria)
    plt.plot([0, 1], [0, 1], linestyle='--', color='gray', label='Clasificación aleatoria')

    # Calculamos y graficamos la curva ROC promedio
    mean_tpr /= cv.get_n_splits(X_train, y_train)
    mean_tpr[-1] = 1.0
    mean_auc = auc(mean_fpr, mean_tpr)
    plt.plot(mean_fpr, mean_tpr, color='blue', linestyle='-', lw=2, label='Curva ROC promedio (AUC = %0.2f)' % mean_auc)

    # Configuramos los ejes y la leyenda
    plt.xlim([-0.05, 1.05])
    plt.ylim([-0.05, 1.05])
    plt.xlabel('Tasa de falsos positivos')
    plt.ylabel('Tasa de verdaderos positivos')
    plt.title('Curva ROC')
    plt.legend(loc="lower right")

    # Mostramos la gráfica de las curvas ROC
    plt.show()
X, Y = getDatos()
X_train, X_test, y_train, y_test = divisionDatos(X, Y)
ROC_AUC(X_train, y_train)

La imagen muestra una curva ROC (Receiver Operating Characteristic) que evalúa el rendimiento de un modelo de clasificación binaria (regresión logística) mediante validación cruzada de 3 pliegues.
Interpretación breve:
-
Ejes:
-
Eje X: Tasa de falsos positivos (FPR).
-
Eje Y: Tasa de verdaderos positivos (TPR).
-
-
Curvas ROC por pliegue:
-
Se visualizan tres curvas (una por cada pliegue de validación), todas con un AUC (Área Bajo la Curva) de 1.00, lo que indica una clasificación perfecta en cada pliegue.
-
-
Línea discontinua gris:
-
Representa la línea base de una clasificación aleatoria, con AUC = 0.5.
-
-
Curva azul gruesa:
-
Es la curva ROC promedio, con AUC = 0.99, lo cual indica un alto rendimiento general del modelo.
-
En resumen, el modelo logra una clasificación casi perfecta en los datos utilizados, con una excelente capacidad para distinguir entre las dos clases.
¿Qué indica la curva ROC y el valor del AUC en la clasificación de datos?
En un modelo de clasificación binaria, cuanto más se aleje la curva ROC de la línea de clasificación aleatoria (diagonal), mejor será el rendimiento del modelo. El objetivo es que la curva se aproxime al punto (0, 1), lo que indica una alta tasa de verdaderos positivos (sensibilidad) y una baja tasa de falsos positivos.
Conclusión
Un AUC alto indica que el modelo es capaz de clasificar de forma precisa y confiable, diferenciando correctamente entre clases como setosa y versicolor. Por tanto, el AUC-ROC es una métrica clave para evaluar la eficacia de modelos en tareas de clasificación binaria.


