


Matriz de confusión machine learning
Una matriz de confusión, es una herramienta utilizada para evaluar el rendimiento de un modelo de clasificación de machine learning. Esta matriz muestra la relación entre las predicciones realizadas por el modelo y las clases reales de un conjunto de datos.
La matriz de confusión está formada por filas y columnas, donde cada fila representa la clase real de los datos y cada columna representa la clase predicha por el modelo.
Interpretación de la Matriz de Confusión y Métricas de Evaluación en Modelos de Machine Learning
La matriz de confusión es una herramienta esencial en la evaluación de modelos de clasificación. Permite visualizar el desempeño del modelo mediante la comparación entre las predicciones y los valores reales.
Diagonales de la Matriz de Confusión
- Diagonal Principal: Representa los valores predichos correctamente por el modelo.
- Diagonal Secundaria: Indica los casos en que el modelo predijo incorrectamente la clase.
Clasificación de Resultados en la Matriz de Confusión
- Verdaderos Positivos (VP): Son los casos en los que el modelo predijo “sí” correctamente.
- Verdaderos Negativos (VN): Son los casos en los que el modelo predijo “no” de forma correcta.
- Falsos Negativos (FN): Son los casos en los que el modelo predijo “no” cuando la respuesta real era “sí”.
- Falsos Positivos (FP): Son los casos en los que el modelo predijo “sí” cuando la respuesta real era “no”.
Principales Métricas de Evaluación
La matriz de confusión permite calcular diversas métricas que ayudan a comprender la eficacia del modelo:
- Error: Porcentaje de predicciones incorrectas.
- Exactitud (Accuracy): Proporción de predicciones correctas en relación al total de casos.
- Precisión (Precision): Mide la proporción de verdaderos positivos respecto al total de casos predichos como positivos.
- Ratios:
- Verdaderos Positivos (TPR o Sensibilidad): Indica la capacidad del modelo para identificar correctamente los casos positivos.
- Falsos Positivos (FPR o 1 – Especificidad): Mide la proporción de negativos incorrectamente clasificados como positivos.
- Verdaderos Negativos (TNR o Especificidad): Indica la capacidad del modelo para identificar correctamente los casos negativos.
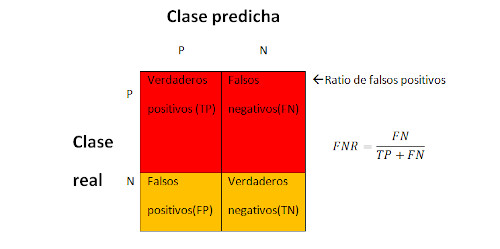
- Falsos Negativos (FNR): Mide la proporción de positivos que fueron clasificados erróneamente como negativos.
- Valor F (F1 Score): Es la media armónica entre la precisión y la sensibilidad, proporcionando un balance entre ambas métricas.
Cálculo del error cometido, la exactitud y la precisión en la matriz de confusión
Error cometido
Es la relación entre las predicciones no correctas y el número total de predicciones

Es la relación entre las predicciones correctas y el número total de muestras del test
| Valores reales | Diferentes predicciones | ||
| 1 | 1 | 1 | 0 |
| 1 | 1 | 0 | 0 |
| 0 | 0 | 0 | 1 |
| 0 | 0 | 0 | 1 |
De los valores totales cuantos ha acertado en cada columna:
- La segunda columna predijo los cuatro correctamente luego su exactitud es de 1
- La tercera columna predijo tres bien pero fallo uno luego la exactitud es 3/4
- La cuarta columna predijo cuatro mal luego la exactitud es 0/4
Precisión

Evalúa la proporción de predicciones positivas realizadas correctamente por el modelo, es decir, la capacidad del modelo para identificar correctamente las instancias positivas, dividiendo el número de verdaderos positivos entre la suma de los verdaderos positivos y los falsos positivos.
| Valores reales | Diferentes predicciones | ||
| 1 | 1 | 1 | 0 |
| 1 | 1 | 0 | 0 |
| 0 | 0 | 0 | 1 |
| 0 | 0 | 0 | 1 |
De los valores totales cuantos ha acertado en cada columna:
- La primera columna predijo 2 correctamente su precisión es de 1
- La segunda columna predijo 1 correctamente su precisión es de 1
- La tercera columna no predijo ningún valor correctamente su precisión es 0
Tipo de ratios de la matriz de confusión
(TPR) Ratio de verdaderos positivos
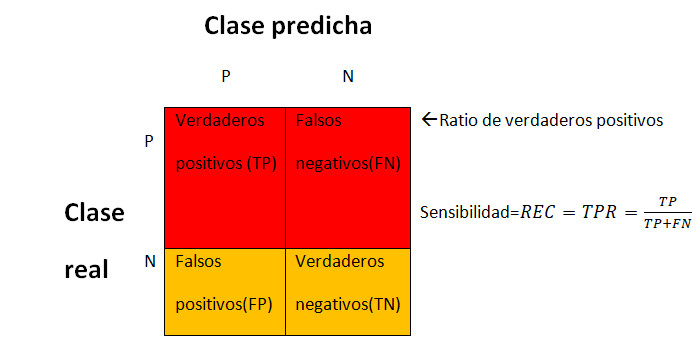
Es la proporción entre los casos positivos que ha clasificado bien el modelo, respecto al total de positivos, también es conocido como sensibilidad, recall o exhaustividad. Se refiere a la proporción de casos positivos que son correctamente clasificados como positivos en relación con el total de casos positivos
Es decir, mide la capacidad del modelo para identificar correctamente los casos positivos.
(FPR) Ratio de los falsos positivos (1-especifidad)
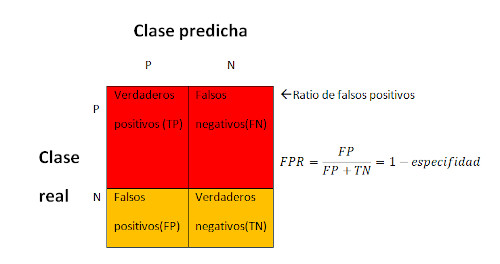
Es la proporción entre los falsos positivos que ha devuelto el modelo, respecto a la suma de los falsos positivos y los verdaderos negativos.
Se refiere a la proporción de casos negativos incorrectamente clasificados como positivos en relación con el total de casos negativos. Es decir, mide la proporción de errores de clasificación en la categoría de falsos positivos.
(TNR) Ratio de los verdaderos negativos (especificad)

(FNR) Ratio de los falsos negativos
El valor F
Es una métrica utilizada para evaluar el rendimiento de un modelo de clasificación a partir de una matriz de confusión. Es una medida de la precisión y exhaustividad del modelo y combina las métricas de precisión y exhaustividad en una sola puntuación.
F=2 * ((precisión * recall) / (precisión + recall))
Implementación de una matriz de confusión con Python
El siguiente código:
- Carga y Preparara de Datos:
- Utiliza Pandas para cargar el dataset directamente desde la URL del repositorio de UCI.
- Se extraen las características (X) y las etiquetas (Y) del dataset.
- Las etiquetas se transforman a un formato numérico mediante LabelEncoder, lo que facilita su procesamiento.
- Divide el Dataset:
- Se divide el conjunto de datos en datos de entrenamiento y datos de prueba utilizando train_test_split, asegurando que la distribución de clases sea proporcional mediante la estratificación.
- Normalización:
- Los datos se normalizan con StandardScaler para que tengan una media de cero y una desviación estándar de uno, lo que ayuda a mejorar el rendimiento del modelo.
- Entrenamiento del Modelo SVM:
- Se define y entrena un modelo de SVC (Support Vector Classifier) de Scikit-Learn. Este modelo se ajusta a los datos normalizados del conjunto de entrenamiento.
- Evaluación del Modelo:
- Tras el entrenamiento, el modelo realiza predicciones sobre el conjunto de prueba.
- Se calculan y muestran métricas clave de evaluación:
- Matriz de Confusión: Permite visualizar el desempeño del modelo en la clasificación de las diferentes clases.
- Precisión (Precision Score)
- Exactitud (Accuracy Score)
- Exhaustividad (Recall Score)
- Valor F1 (F1 Score)
import pandas as pd
from sklearn.metrics import precision_score
from sklearn.metrics import accuracy_score
from sklearn.metrics import recall_score
from sklearn.metrics import confusion_matrix
from sklearn.metrics import f1_score
from sklearn.preprocessing import LabelEncoder
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC
def getDatos():
    datos = pd.read_csv('https://archive.ics.uci.edu/ml/'
                 'machine-learning-databases'
                 '/breast-cancer-wisconsin/wdbc.data', header=None)
    X = datos.loc[:,2:].values
    Y = datos.loc[:,1].values
    return X,Y
def transformacionEtiquetas(Y):
    labelEncoder = LabelEncoder()
    y = labelEncoder.fit_transform(Y)
    return y
def divisionDatos(X,Y):
    X_train, X_test, y_train, y_test = train_test_split(X, Y,
                     test_size=0.20,
                     stratify=Y,
                     random_state=1)
    return X_train, X_test, y_train, y_test
def normalizacion(X_train,X_test):
    #Normalizamos los datos
    normalizar = StandardScaler()
    X_train_std = normalizar.fit_transform(X_train)
    X_test_std = normalizar.transform(X_test)
    return X_train_std, X_test_std
X,Y = getDatos()
Y = transformacionEtiquetas(Y)
X_train, X_test, y_train, y_test = divisionDatos(X,Y)
X_train_std, X_test_std=normalizacion(X_train,X_test)
svc = SVC(random_state=1)
svc.fit(X_train_std,y_train)
y_predic = svc.predict(X_test_std)
print('La matriz de confusion es: ')
print(confusion_matrix(y_test,y_predic))
print('La precision es: ',precision_score(y_test,y_predic))
print('La exactitud es: ',accuracy_score(y_test,y_predic))
print('La exahustividad es: ',recall_score(y_test,y_predic))
print('El valor f1 es: ',f1_score(y_test,y_predic))
[[71 1]
[ 2 40]]
La precision es: 0.975609756097561
La exactitud es: 0.9736842105263158
La exahustividad es: 0.9523809523809523
El valor f1 es: 0.963855421686747


