

El algoritmo PCA o análisis de componentes principales es un método supervisado que se utiliza para la reducción de la dimensionalidad, donde vamos a reducir la dimensionalidad de un conjunto de datos que consta de muchas variables correlacionadas entre sí, vamos a transformar las variables en un nuevo conjunto de variables que es una combinación de variables o atributos de nuestro conjunto de datos original de tal manera que se conserva la máxima variación, ademas de ello vamos a mejorar la eficiencia y el rendimiento de los algoritmos de machine learning.
Como implementar el algoritmo PCA en Python
Los siguientes pasos que vamos a aplicar son:
-
Estandarizamos el conjunto de datos de d dimensiones.
-
Obtenemos la matriz de covarianza.
-
Calculamos los autovalores y autovectores de la matriz de covarianza.
-
Ordenamos los autovalores para clasificar los autovectores.
-
Seleccionamos k autovectores que correspondan a los k autovalores más altos.
-
Construimos la matriz de proyección W a partir de estos k autovectores.
-
Transformamos los datos originales X (de d dimensiones) al nuevo subespacio reducido de k dimensiones.
Búsqueda de los componentes CP1 y CP2
Los componentes CP1 y CP2 que serán los auto vectores de la matriz de covarianza:
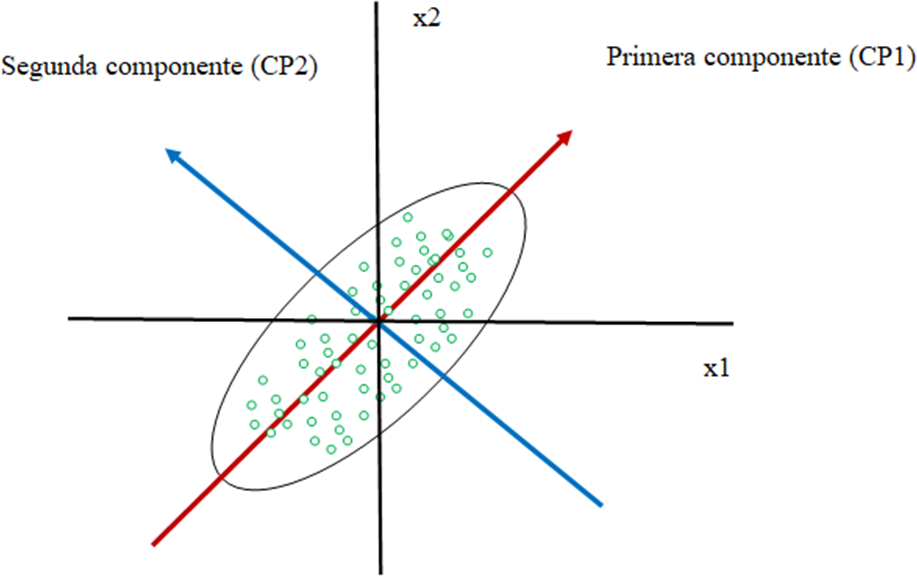
Implementación del algoritmo PCA de dos características de datos proyectados sobre una recta
Si tenemos la siguiente tabla:
| X | Y |
| 1 | 3 |
| 1 | 4 |
| 2 | 5 |
| 2 | 7 |
| 3 | 6 |
| 3 | 8 |
| 5 | 6 |
| 5 | 8 |
Generación de la matriz de covarianza
LLamamos a la función np.cov(matrizDatos) de la clase numpy para que nos genere la matriz:
matrizDatos = np.array([(1,1,2,2,3,3,5,5),(3,4,5,7,6,8,6,8)])
matrizCovarianza=np.cov(matrizDatos)
| 2.5 | 1.96428571 |
| 1.96428571 | 3.26785714 |
Si tenemos la función definida por:
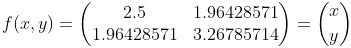
Función de R2 a R2 que transforma un vector en otro vector
Búsqueda de los autovalores y autovectores
Buscamos los autovalores y autovectores de esa matriz, que seran nuestras componentes CP1 y CP2, cuyos autovectores seran ortogonales cuyo producto escalar es cero.
autovalores, autovectores = np.linalg.eig(matrizCovarianza)
- λ1 0.8824742213855528 asociado al autovector (-0.77195362, 0.63567885)
- λ2 4.8853829214715905 asociado al autovector (-0.63567885, -0.77195362) ***cogemos este que tiene la mayor variabilidad
Nota: Como la librería Numpy da los autovectores con signos invertidos los cambiamos.
Ordenación de los autovectores
Ordenamos los autovectores de mayor a menor según λ
- PC1 –> (0.63567885, 0.77195362)
- PC2 –> (0.77195362, -0.63567885)
Finalmente proyectamos nuestros puntos sobre la primera componente principal que es la que mayor variabilidad de datos tiene (PC1)
La función definida que tiene por matriz de proyección W el mayor autovector es decir la componente PC1:
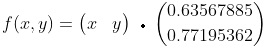
función de R2 a R
A esa función le pasamos los datos de entrada para hacer la proyección dando como resultado:
| 2.95153972 |
| 3.72349335 |
| 5.13112582 |
| 6.67503307 |
| 6.5387583 |
| 8.08266555 |
| 7.810116 |
| 9.35402325 |
Codigo de implementacion
El siguiente codigo en Python implementa paso a paso una visualización del análisis de componentes principales (PCA) aplicado a un conjunto de datos bidimensional. Aquí tienes una descripción breve y clara de lo que hace cada parte:
Objetivo del código:
Ilustrar gráficamente cómo funciona el Análisis de Componentes Principales (PCA), mostrando los autovectores (componentes principales), los datos originales y sus proyecciones sobre el primer componente principal.
Resumen del funcionamiento del código:
-
Generación de datos:
Crea una matriz de datos con 8 puntos bidimensionales.
-
Cálculo de matriz de covarianza:
Se obtiene la matriz de covarianza del conjunto de datos, que indica la relación lineal entre las dos variables.
-
Extracción de autovalores y autovectores:
Se obtienen los autovalores (importancia de cada componente) y autovectores (direcciones principales).
-
Ordenación de componentes principales:
Se seleccionan los 2 autovectores más significativos, es decir, los que explican mayor varianza.
-
Proyección sobre el primer componente principal:
Cada punto es proyectado sobre el primer componente principal para reducir la dimensionalidad.
-
Visualización de resultados:
Dibuja:
-
Los datos originales.
-
Las rectas que representan los componentes principales.
-
Las proyecciones de los datos sobre el componente principal.
-
import numpy as np
import matplotlib.pyplot as plt
def dibujarMatriz(matrizDatos,pc1, pc2,arrayProyecciones):
    #Pinta nuestros datos
     plt.scatter(matrizDatos[:][0],matrizDatos[:][1])
     #Inicializa las variables
     rectaAutovector1_x=[]
     rectaAutovector1_y=[]
     rectaAutovector2_x=[]
     rectaAutovector2_y=[]
     x=[]
     y=[]

     #Genera la recta del autovector 1
     for lamda in np.arange(0,15.2,0.2):
         lamda=np.round(lamda, 2)
         x1 = 0 + lamda * pc1[0]
         x2 = 0 + lamda * pc1[1]
         rectaAutovector1_x.append(x1)
         rectaAutovector1_y.append(x2)
     #Genera la recta del autovector 2
     for lamda in np.arange(-15,0.2,0.2):
         lamda=np.round(lamda, 2)
         x1 = 0 + lamda * pc2[0]
         x2 = 0 + lamda * pc2[1]
         rectaAutovector2_x.append(x1)
         rectaAutovector2_y.append(x2)
     #Dibuja las rectas de los autovectores
     plt.plot(rectaAutovector1_x,rectaAutovector1_y,label='autovector1')
     plt.plot(rectaAutovector2_x,rectaAutovector2_y,label='autovector2')
     plt.legend(loc="lower right")
     #Proyecta los datos sobre el vector de componentes p1
     for i in range(0,8):
        v = arrayProyecciones[i]
        x.append(v[0])
        y.append(v[1])
     plt.scatter(x,y)
     # Escala de los ejes
     plt.xlim(-10,10)
     plt.ylim(-10,10)
     plt.grid(True)
     plt.show()
def getDatos():
    matrizDatos = np.array([(1,1,2,2,3,3,5,5),(3,4,5,7,6,8,6,8)])
    return matrizDatos
def getMatrizCovarianza(matrizDatos):
    return np.cov(matrizDatos)
def getAutovaloresVectores(matrizCovarianza):
    autovalores, autovectores = np.linalg.eig(matrizCovarianza)
    return autovalores, autovectores
def getOrdenAutovalores(autovalores, autovectores):
    # Hacemos una lista de las tuplas (autovalor, autovector)
    paresAutoVecAutoVal = [(np.abs(autovalores[i]), autovectores[:, i])
                           for i in range(len(autovalores))]
    return paresAutoVecAutoVal
def getMayoresAutovalores(paresAutoVecAutoVal):
     # Ordenamos las tuplas de mayor a menor
    paresAutoVecAutoVal.sort(key=lambda k: k[0], reverse=True)
    #Devolvemos los dos primeros autovectores y le añadimos una dimension extra
    a = paresAutoVecAutoVal[0][1][:, np.newaxis]
    b = paresAutoVecAutoVal[1][1][:, np.newaxis]
    lamda1 = paresAutoVecAutoVal[0][0]
    lamda2 = paresAutoVecAutoVal[1][0]
    a = a*(-1)
    b = b*(-1)
    return a, b, lamda1, lamda2
def getModuloVector(u):
    return np.linalg.norm(u)
def getArrayProyeccionesSobrePC1(w,a):
    #Vamos a calcular las proyecciones de cada punto sobre
    arrayProyecciones = []
    for i in range(0,8):
      s = a*w[i]
      arrayProyecciones.append(s)
    return arrayProyecciones
def productoEscalar(u,v):
  s = np.dot(u,v)
  return s
matrizDatos=getDatos()
matrizCovarianza=getMatrizCovarianza(matrizDatos)
print(matrizCovarianza)
autovalores, autovectores = getAutovaloresVectores(matrizCovarianza)
paresAutoVecAutoVal = getOrdenAutovalores(autovalores, autovectores)
# Seleccionamos 2 autovectores que correspondan a los k autovalores mayores
a, b,lamda1,lamda2 = getMayoresAutovalores(paresAutoVecAutoVal)
matrizDatosTranspuesta = matrizDatos.T
w = matrizDatosTranspuesta.dot(a)
arrayProyeccionesSobrePC1=getArrayProyeccionesSobrePC1(w,a)
dibujarMatriz(matrizDatos,a, b,arrayProyeccionesSobrePC1)
Salida
Donde los datos proyectados son el producto escalar de estos datos de los datos de la tabla anterior con el vector de la matriz de proyección dando como resultado:

Los datos azules al proyectarse van a caer sobre la recta en la dirección del mayor autovalor o la PC1
Implementación de algoritmo de PCA sobre el set de datos wine
En el siguiente set datos de wine vamos a transformar un espacio de 13 dimensiones a un espacio de 2 dimensiones, mostrando como predice en las dimensiones originales y la dimensiones reducidas.
Codigo en python
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import confusion_matrix
from sklearn.metrics import accuracy_score
def getDatos():
    # Lectura de datos
    wine = pd.read_csv("wine.csv")
    X = wine.iloc[:, 1:14].values
    Y = wine.iloc[:, 0].values
    return X,Y
def getDivisionDatos(X,Y):
    # Division del conjunto de los datos
    X_train, X_test, Y_train, Y_test = train_test_split(
    X, Y, test_size=0.3, random_state=1, stratify=Y)
    return X_train, X_test, Y_train, Y_test
def getOrdenAutovalores(autovalores, autovectores):
    # Hacemos una lista de las tuplas (autovalor, autovector)
    paresAutoVecAutoVal = [(np.abs(autovalores[i]), autovectores[:, i])
                           for i in range(len(autovalores))]
    return paresAutoVecAutoVal
def getMatrizProyeccion(a, b):
    # Funcion R13x1 --> R13x2 definida por la union de dos columnas (13x1) y (13x1)
    matrizProyeccion = np.hstack((a, b))
    return matrizProyeccion
def getMayoresAutovalores(paresAutoVecAutoVal):
     # Ordenamos las tuplas de mayor a menor
    paresAutoVecAutoVal.sort(key=lambda k: k[0], reverse=True)
    #Devolvemos los dos primeros autovectores y le añadimos una dimension extra
    a = paresAutoVecAutoVal[0][1][:, np.newaxis]
    b = paresAutoVecAutoVal[1][1][:, np.newaxis]
    return a, b
def estandarizacionDatos(X_train, X_test):
    sc = StandardScaler()
    sc.fit(X_train)  # Estima los parametros u y o para dimension de los datos
    X_train_std = sc.fit_transform(X_train)
    X_test_std = sc.transform(X_test)
    return X_train_std, X_test_std
def getMatrizCovarianza(X_train_std):
    matrizCovarianza = np.cov(X_train_std.T)
    return matrizCovarianza
def getAutovaloresVectores(matrizCovarianza):
    autovalores, autovectores = np.linalg.eig(matrizCovarianza)
    return autovalores, autovectores
def predicion(texto,X_train_std,X_test_std,Y_train,Y_test):
    print(texto)
    lr = LogisticRegression()
    lr.fit(X_train_std,Y_train)
    Y_predic = lr.predict(X_test_std)
    metricas(Y_test,Y_predic)
def metricas(Y_test,Y_predic):
    exactitud = accuracy_score(Y_test,Y_predic)
    print("Exactitud del modelo:")
    print(exactitud)
    matriz = confusion_matrix(Y_test,Y_predic)
    print('Matriz de confusion:')
    print(matriz)
    print()
def datosReducidos(X,W):
    M= np.dot(X,W)
    return M
X,Y = getDatos()
X_train, X_test, Y_train, Y_test = getDivisionDatos(X,Y)
# Estandarizacion de datos
X_train_std, X_test_std = estandarizacionDatos(X_train, X_test)
# Obtenemos de la matriz de covarianza
matrizCovarianza = getMatrizCovarianza(X_train_std)
# Pedimos los autovalores y autovectores a la matriz de covarianza
autovalores, autovectores = getAutovaloresVectores(matrizCovarianza)
# Ordenamos los autovalores por orden decreciente segun los autovectores
paresAutoVecAutoVal = getOrdenAutovalores(autovalores, autovectores)
# Seleccionamos 2 autovectores que correspondan a los k autovalores mayores
a, b = getMayoresAutovalores(paresAutoVecAutoVal)
# Obtenemos la matriz de proyeccion W a partir de los k autovectores
matrizProyeccion = getMatrizProyeccion(a, b)
#Realizamos el producto xW con los datos de entrenamiento
X_train_stdR=datosReducidos(X_train_std,matrizProyeccion)
#Realizamos el producto xW con los datos de test
X_test_stdR=datosReducidos(X_test_std,matrizProyeccion)
predicion("Predicion sin reducir",X_train_std,X_test_std,Y_train,Y_test)
predicion("Predicion modo reducido",X_train_stdR,X_test_stdR,Y_train,Y_test)
Salida
Predicion sin reducir
Exactitud del modelo:
0.9814814814814815
Matriz de confusion:
| 18 | 0 | 0 |
| 0 | 20 | 1 |
| 0 | 0 | 15 |
Predicion modo reducido
Exactitud del modelo:
0.9814814814814815
Matriz de confusion:
| 18 | 0 | 0 |
| 1 | 20 | 0 |
| 0 | 0 | 15 |
PCA sobre el set de datos wine usando la libreria scikit learn
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
import pandas as pd
from sklearn.decomposition import PCA
from sklearn.linear_model import LogisticRegression
from matplotlib.colors import ListedColormap
import matplotlib.pyplot as plt
import numpy as np
from sklearn.metrics import precision_score
from sklearn.metrics import confusion_matrix
from sklearn.metrics import accuracy_score
def getDatos():
# Lectura de datos
wine = pd.read_csv("wine.csv")
X = wine.iloc[:, 1:14].values
Y = wine.iloc[:, 0].values
return X,Y
def getDivisionDatos(X,Y):
# Division del conjunto de los datos
X_train, X_test, Y_train, Y_test = train_test_split(
X, Y, test_size=0.3, random_state=1, stratify=Y)
return X_train, X_test, Y_train, Y_test
def estandarizacionDatos(X_train, X_test):
sc = StandardScaler()
sc.fit(X_train) # Estima los parametros u y o para dimension de los datos
X_train_std = sc.fit_transform(X_train)
X_test_std = sc.transform(X_test)
return X_train_std, X_test_std
def entrenamiento(numeroComponentes,X_train_std,X_test_std):
pca = PCA(n_components=numeroComponentes)
X_train_pca = pca.fit_transform(X_train_std)
X_test_pca = pca.transform(X_test_std)
lr = LogisticRegression()
lr.fit(X_train_pca,Y_train)
return X_train_pca, X_test_pca,lr
def regionesDecision(X, y, X_prueba, clasificador, mostrarDatosPrueba , resolution=0.02):
marcas = ('s', 'x', 'o', '^', 'v')
colores= ('red','black','blue','green','yellow')
clases=np.unique(y)
arrayColores=colores[:len(clases)]
listedColormap = ListedColormap(arrayColores)
rangoA= np.arange(X[:,0].min()-1,X[:,0].max()+1,resolution)
rangoB= np.arange(X[:,1].min()-1,X[:,1].max()+1,resolution)
xx, yy = np.meshgrid(rangoA,rangoB)
s= np.array([xx.ravel(), yy.ravel()]).T
Z = clasificador.predict(s)
Z = Z.reshape(xx.shape)
plt.contourf(xx, yy, Z, alpha=0.3, cmap=listedColormap)
for a, b in enumerate(clases):
plt.scatter(x=X[y == b, 0],
y=X[y == b, 1],
alpha=0.8,
c=colores[a],
marker=marcas[a],
label=b,
edgecolor='black')

if (mostrarDatosPrueba):
plt.scatter(X_prueba[:, 0],
X_prueba[:, 1],
c='',
edgecolor='red',
alpha=1.0,
linewidth=1,
marker='o',
s=100,
label='test set')
plt.xlabel('PC 1')
plt.ylabel('PC 2')
plt.legend(loc='lower left')
plt.tight_layout()
plt.savefig('trainRegionesDecision.jpg', dpi=150)
plt.show()
def metricas(Y_test,Y_predic):
exactitud = accuracy_score(Y_test,Y_predic)
print("Exactitud del modelo:")
print(exactitud)
matriz = confusion_matrix(Y_test,Y_predic)
print('Matriz de confusion:')
print(matriz)
print()
def getDatosReducidos(X_train_std,X_test_std,numeroComponentes):
pca = PCA(n_components=numeroComponentes)
X_train_pca = pca.fit_transform(X_train_std)
X_test_pca = pca.transform(X_test_std)
return X_train_pca,X_test_pca
def predicion(texto,X_train_std,X_test_std,Y_train,Y_test):
print(texto)
lr = LogisticRegression()
lr.fit(X_train_std,Y_train)
Y_predic = lr.predict(X_test_std)
metricas(Y_test,Y_predic)
X,Y = getDatos()
X_train, X_test, Y_train, Y_test = getDivisionDatos(X,Y)
# Estandarizacion de datos
X_train_std, X_test_std = estandarizacionDatos(X_train, X_test)
#Transformacion de datos para dos componentes
X_train_pca, X_test_pca, lr = entrenamiento(2,X_train_std,X_test_std)
y_predic = lr.predict(X_test_pca)
X_train_pca,X_test_pca= getDatosReducidos(X_train_std,X_test_std,2)
predicion("Predicion sin reducir",X_train_std,X_test_std,Y_train,Y_test)
predicion("Predicion modo reducido",X_train_pca,X_test_pca,Y_train,Y_test)
Salida
Predicion sin reducir
Exactitud del modelo:
0.9814814814814815
Matriz de confusion:
| 18 | 0 | 0 |
| 0 | 20 | 1 |
| 0 | 0 | 15 |
Predicion modo reducido
Exactitud del modelo:
0.9814814814814815
Matriz de confusion:
| 18 | 0 | 0 |
| 1 | 20 | 0 |
| 0 | 0 | 15 |


