

Word2Vec: qué es, cómo funciona y por qué fue clave en el PLN
El Procesamiento del Lenguaje Natural (PLN) ha transformado la forma en que las máquinas entienden el lenguaje humano.
Uno de los modelos que marcó un antes y un después en esta evolución fue Word2Vec, una técnica que permitió a los ordenadores representar el significado de las palabras en forma numérica.
En este artículo descubrirás qué es Word2Vec, cómo funciona, cuál es su historia, sus ventajas, limitaciones y cómo se utiliza hoy en día.
¿Qué es Word2Vec?
Word2Vec es un modelo de aprendizaje profundo desarrollado por investigadores de Google en 2013, liderados por Tomas Mikolov, que convierte las palabras en vectores numéricos (también llamados embeddings).
Cada palabra se representa como un punto en un espacio de muchas dimensiones, donde las distancias reflejan relaciones semánticas.
En otras palabras, palabras con significados similares tienen vectores cercanos.
Ejemplo clásico:
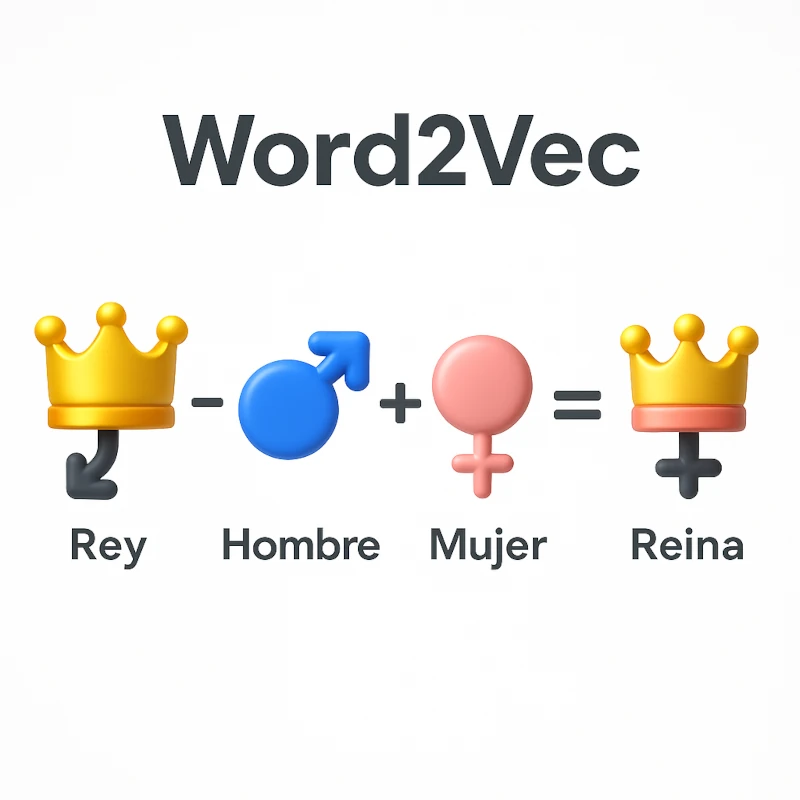
vector(“rey”) – vector(“hombre”) + vector(“mujer”) ≈ vector(“reina”)
Esto significa que el modelo entiende que “rey” y “reina” tienen una relación de género similar a “hombre” y “mujer”.
Breve historia de Word2Vec
Antes de Word2Vec, los modelos de PLN representaban palabras con métodos muy básicos, como:
- Bolsa de palabras (Bag of Words), que solo contaba frecuencias.
- TF-IDF, que medía la relevancia de una palabra en un texto.
Estos enfoques eran útiles, pero no captaban significados ni relaciones entre palabras.
Con la llegada de Word2Vec en 2013, se introdujo la idea de embeddings semánticos:
- Se usaron redes neuronales simples con una capa oculta.
- Se entrenaron con millones de frases para aprender las relaciones de contexto.
Resultado: las máquinas empezaron a “entender” similitudes como
“Rey” está a “Reina” como “Hombre” está a “Mujer”,
algo imposible con las técnicas anteriores.
¿Cómo funciona Word2Vec?
Word2Vec se entrena con dos posibles arquitecturas:
1. CBOW (Continuous Bag of Words)
Predice una palabra según las palabras de su contexto.
Por ejemplo:
“El ___ está maullando” → predice “gato”.
2. Skip-Gram
Hace lo contrario: predice el contexto a partir de una palabra.
“gato” → “El”, “está”, “maullando”.
Ambos modelos permiten aprender qué palabras tienden a aparecer juntas, captando así su significado y uso en el lenguaje.
¿Para qué se usa Word2Vec hoy en día?
Aunque modelos más avanzados como BERT o GPT han superado a Word2Vec,
sigue siendo muy útil en muchas aplicaciones prácticas donde la simplicidad y rapidez son importantes:
- Búsqueda semántica → encontrar documentos o productos con significados similares.
- Análisis de sentimientos → representar frases o reseñas en vectores para clasificarlas.
- Recomendadores de contenido → encontrar relaciones entre descripciones o comentarios.
- Agrupamiento de palabras (clustering) → descubrir temas o categorías latentes en textos.
- Reducción de dimensionalidad → representar textos en espacios más compactos.
Ventajas de Word2Vec
| Ventaja | Descripción |
| Simplicidad y eficiencia | Su arquitectura neuronal es ligera y fácil de entrenar. |
| Captura relaciones semánticas | Aprende similitudes entre palabras y conceptos. |
| Reduce dimensionalidad | Representa vocabularios grandes en pocos cientos de dimensiones. |
| Reutilizable | Los modelos preentrenados se pueden aplicar a muchos dominios. |
| Rápido en inferencia | Ideal para proyectos con recursos limitados. |
Limitaciones de Word2Vec
| Limitación | Consecuencia |
| No entiende contexto | “Gato” tendrá el mismo vector en “Gato del coche” y “Gato animal”. |
| Una palabra = un vector | No distingue significados múltiples (polisemia). |
| No capta estructura gramatical | Ignora el orden de las palabras y las relaciones sintácticas. |
| No maneja palabras nuevas (OOV) | Si una palabra no se vio durante el entrenamiento, no puede representarse. |
| Requiere mucho texto limpio | Necesita grandes volúmenes de datos para ser preciso. |
Word2Vec frente a los modelos modernos
Aunque hoy dominan modelos como BERT, RoBERTa o GPT,
Word2Vec sigue siendo una base fundamental del PLN moderno.
De hecho, su filosofía de representar el lenguaje mediante vectores semánticos
fue el punto de partida para los actuales Transformers y modelos de gran lenguaje (LLMs).
Actualmente, se usa principalmente en:
- Tareas educativas y de investigación.
- Análisis exploratorios rápidos.
- Sistemas ligeros donde no se puede usar un modelo Transformer por recursos limitados.
Conclusión
Word2Vec revolucionó el Procesamiento del Lenguaje Natural al permitir representar las palabras con significado, no solo con frecuencia.
Fue el primer paso hacia una comprensión semántica profunda del lenguaje por parte de las máquinas.
Aunque hoy los Transformers como BERT y GPT dominan el campo,
Word2Vec sigue siendo una herramienta valiosa, especialmente en proyectos pequeños, educativos o de bajo costo computacional.


