

Underfitting y overfitting
En esta entrada vamos a profundizar en dos conceptos fundamentales del aprendizaje automático: overfitting y underfitting.
Cuando entrenamos un modelo, buscamos que el algoritmo sea capaz de generalizar, es decir, que pueda ofrecer resultados fiables frente a datos nuevos que no ha visto antes. Si el modelo se entrena con muy pocos datos o con un enfoque demasiado simple, no captará correctamente los patrones y cometerá errores. Este problema se conoce como underfitting o subajuste.
Por ejemplo, si enseñamos a un modelo imágenes de una sola clase de flores y luego le pedimos que reconozca otras clases, fallará porque no ha aprendido la diversidad de patrones necesarios.
En cambio, si entrenamos el modelo con datos demasiado específicos, como flores de un solo color (flores rojas), y luego le mostramos una flor blanca, es probable que no la reconozca. Esto ocurre porque el modelo ha aprendido en exceso los detalles del conjunto de entrenamiento, incluyendo particularidades o ruido, y no generaliza bien. Este fenómeno se llama overfitting o sobreajuste.
¿Qué es el overfitting y el underfitting?
Overfitting (Sobreajuste):
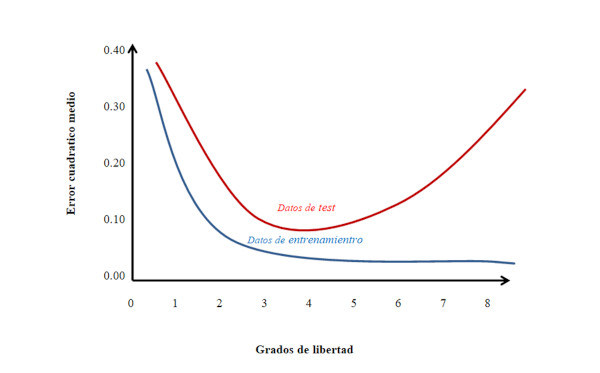
Sucede cuando el modelo se ajusta demasiado a los datos de entrenamiento, incluyendo ruido y valores atípicos, lo que disminuye su capacidad para generalizar.
Características del overfitting:
- Muchos grados de libertad.
- Bajo sesgo y alta varianza.
- Aprende también detalles irrelevantes del entrenamiento.
Underfitting (Subajuste):
Ocurre cuando el modelo es demasiado simple y no logra captar adecuadamente las relaciones entre variables.
Características del underfitting:
- Pocos grados de libertad.
- Alto sesgo y baja varianza.
- No identifica correctamente los patrones de los datos.
Cómo mejorar el underfitting:
- Aumentar los datos de entrenamiento.
- Seleccionar características relevantes.
- Ajustar los hiperparámetros del modelo.
- Reducir la regularización si es excesiva.
¿Cómo saber si mi modelo tiene overfitting?
Para identificar si tu modelo tiene overfitting, compara la precisión en el conjunto de entrenamiento con la de validación. Si la precisión es muy alta en el entrenamiento, pero baja en la validación, es un claro indicio de sobreajuste. También puedes usar curvas de validación: si observas que la curva de entrenamiento está muy por encima de la de validación, significa que el modelo está memorizando los datos de entrenamiento y no generaliza correctamente.
¿Qué es el sobreajuste y el subajuste con un ejemplo?
Overfitting (Sobreajuste):
Sucede cuando el modelo aprende en exceso los detalles del conjunto de entrenamiento, incluyendo el ruido, y falla ante nuevos datos.
Ejemplo con el dataset Iris:
Si entrenas un modelo solo con flores de la especie Iris-setosa, el modelo aprenderá detalles muy específicos de esa clase. Pero al presentarle una Iris-versicolor, no podrá clasificarla correctamente.
Underfitting (Subajuste):
Se da cuando el modelo es demasiado simple y no capta bien los patrones de los datos.
Ejemplo con el dataset Iris:
Si utilizas un modelo muy básico que solo analiza la longitud del pétalo para clasificar las flores, probablemente no podrá diferenciar entre Iris-setosa, Iris-versicolor e Iris-virginica, porque necesita más información para hacerlo correctamente.
¿Qué es el sesgo y la varianza en machine learning?
- Sesgo:
Se refiere al error que comete el modelo al simplificar demasiado el problema. Un modelo con alto sesgo no captura la complejidad de los datos y genera errores sistemáticos. - Varianza:
Es la sensibilidad del modelo a las variaciones de los datos de entrenamiento. Un modelo con alta varianza se ajusta demasiado a los datos de entrenamiento y sus predicciones cambian mucho con nuevos datos.
¿Qué relaciones existen entre Underfitting, Overfitting y Sesgo-Varianza?
| Situación | Sesgo | Varianza | Explicación |
| Underfitting (Subajuste) | Alto sesgo | Baja varianza | El modelo es demasiado simple y no aprende los patrones, fallando en entrenamiento y validación. |
| Overfitting (Sobreajuste) | Bajo sesgo | Alta varianza | El modelo es muy complejo, memoriza los datos de entrenamiento y no generaliza bien. |
| Buen equilibrio | Bajo sesgo | Baja varianza | El modelo aprende los patrones correctamente sin memorizar el ruido, generalizando bien a nuevos datos. |


