
La regresión lineal
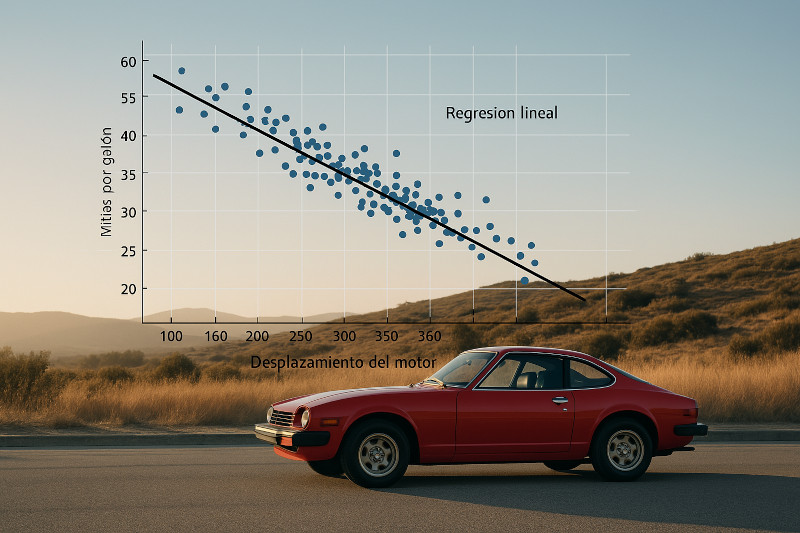
En esta guía te mostraremos la regresion lineal con auto mpg y cómo analizar el conjunto de datos visualizando sus características mediante matrices de dispersión y correlación, y te explicaremos por qué es clave elegir la variable con mayor correlación lineal para una regresión efectiva.
Además, descubrirás la diferencia entre dos métodos fundamentales: Descenso del Gradiente y Mínimos Cuadrados Ordinarios (OLS). También incluimos ejemplos prácticos de ambos enfoques, junto a un modelo con tres variables utilizando OLS, para que puedas aplicarlos en tus propios proyectos de machine learning
Conjunto de datos dataset para la regresión lineal con auto mpg
El conjunto de datos Auto MPG contiene información sobre más de 400 vehículos, incluyendo:
- mpg: Consumo en millas por galón.
- cylinders: Número de cilindros del motor.
- displacement: Desplazamiento del motor (cc).
- horsepower: Potencia del motor (hp).
- weight: Peso del vehículo.
- acceleration: Tiempo de aceleración de 0 a 60 mph.
- model year: Año del modelo.
- origin: Región de origen (1: USA, 2: Europa, 3: Japón).
¿Cómo ver las relaciones entre variables?
La matriz de dispersión muestra las relaciones entre variables en forma de gráficos (visual, con puntos).
La matriz de correlación muestra las relaciones en forma numérica (valores entre -1 y 1).
🔍 En resumen:
- La matriz de dispersión te deja ver las relaciones.
- La matriz de correlación te dice cuánto se relacionan.
¿Cómo visualizar las características del conjunto de datos Dataset Auto-MPG mediante la matriz de dispersion?
La visualización de un conjunto de datos mediante una matriz de dispersión en regresión lineal sirve para:
- Detectar relaciones lineales entre variables.
- Identificar las variables más útiles para hacer predicciones.
- Observar patrones, tendencias y outliers (valores atípicos).
- Ayudar a elegir las variables explicativas del modelo.
En resumen: te permite ver qué tan bien se relacionan las variables con la que quieres predecir, de forma visual y rápida.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
def visualizarRelaciones(datos):
    columnas = ['mpg','cylinders','displacement','horsepower','weight','acceleration','model year','origin']
    sns.pairplot(datos[columnas], height=2.5)
    plt.savefig('RegresionLineal/auto.png', dpi=300)
    plt.show()

def leerDatos():
    datos = pd.read_csv('RegresionLineal/auto-mpg.csv',encoding='utf-8')
    #Leemos todos los datos menos la ultima columna
    datos = datos.iloc[:, :-1]
    # Convertir todos los datos en enteros en flotantes
    datos = datos.astype('float', errors='ignore')
    datos.columns = ['mpg','cylinders','displacement','horsepower','weight','acceleration','model year','origin']
    datos.head()
    return datos
datos = leerDatos()
visualizarRelaciones(datos)
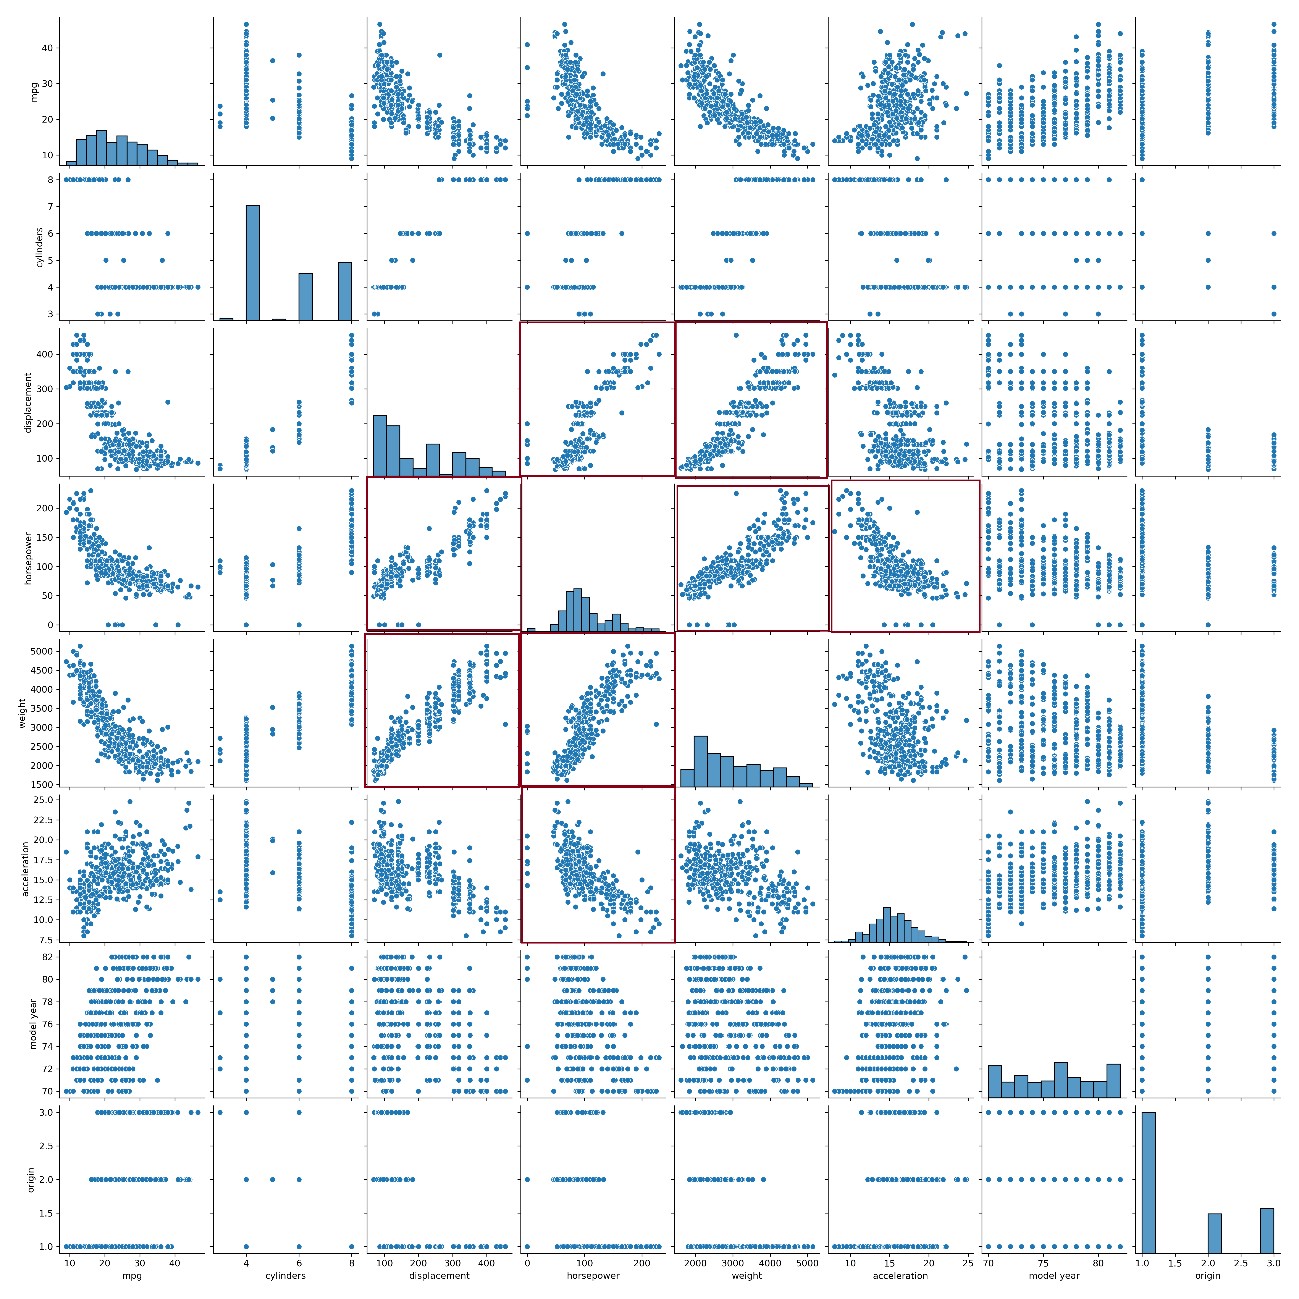
En el grafico anterior vemos que existen relaciones lineales entre:
- Displacement y el Weight
- Displacement y el horsepower
- Horsepower(potencia) y la aceleración
- Horsepower y la Weight
- Weight y horsepower
Donde vemos también que en el gráfico:
Existe una distribución normal en las variables aceleración y horsepower.
¿Cómo observar las relaciones mediante una matriz de correlación?
La observación de la matriz de correlación en regresión lineal sirve para:
- Identificar qué variables tienen mayor relación con la variable que queremos predecir.
- Seleccionar las variables más útiles para el modelo.
- Detectar relaciones positivas o negativas entre variables.
En resumen: ayuda a elegir las mejores variables explicativas basándose en su nivel de correlación con la variable objetivo.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
def leerDatos():
    datos = pd.read_csv('RegresionLineal/auto-mpg.csv',encoding='utf-8')
    datos = datos.iloc[:, :-1]
    # Convertir todos los datos en enteros en flotantes
    datos = datos.astype('float', errors='ignore')
    datos.columns = ['mpg','cylinders','displacement','horsepower','weight','acceleration','model year','origin']
    datos.head()
    return datos
def mostrarCorrelaciones(datos,columnas):
    b = datos[columnas].values.T
    cm = np.corrcoef(b)
    sns.set(font_scale=1.5)
    hm = sns.heatmap(cm,
                    cbar=True,
                    annot=True,
                    square=True,
                    fmt='.2f',
                    annot_kws=,
                    yticklabels=columnas,
                    xticklabels=columnas)

    plt.tight_layout()
    plt.savefig('RegresionLineal/auto2.png', dpi=300)
    plt.show()
datos = leerDatos()
columnas = ['mpg','cylinders','displacement','horsepower','weight','acceleration','model year','origin']
mostrarCorrelaciones(datos,columnas)
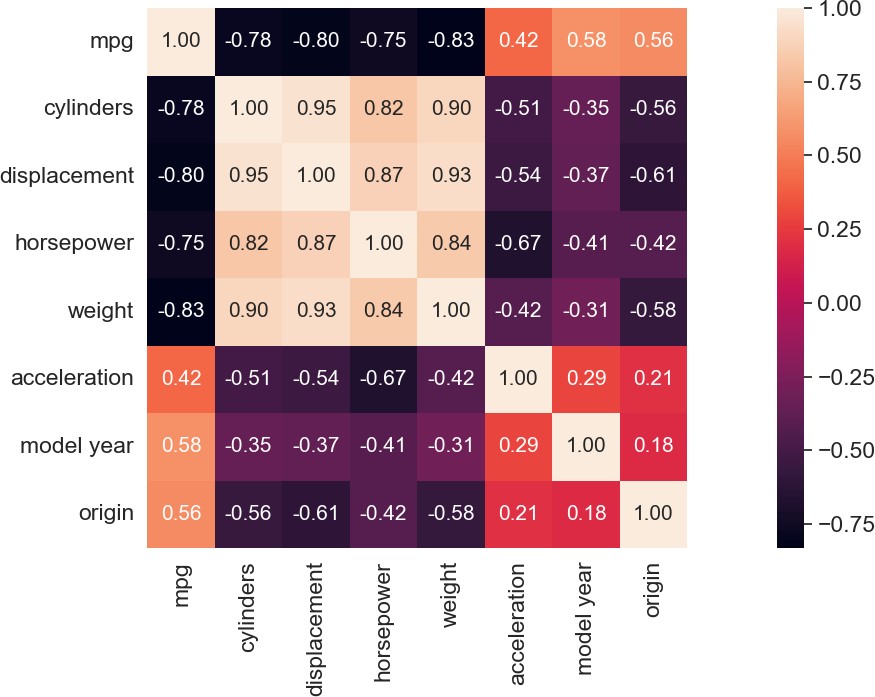
Nos interesan las variables displacement y el horsepower que tienen una relación lineal ya que a mayor desplazamiento en el motor hay más caballos de potencia.
¿Por qué se escoge la variable con mayor correlación lineal para la regresión?
1. La regresión lineal modela relaciones lineales
La regresión lineal simple o múltiple busca ajustar una línea recta (o un hiperplano) que relacione las variables independientes con la variable dependiente.
Si una variable tiene una relación lineal fuerte con la variable objetivo, el modelo podrá predecir con más precisión, ya que esa relación puede ser capturada eficientemente por la ecuación lineal:
y=β0 + β1×1+⋯+ βnxn+ ϵy +ϵ
2. La correlación alta indica poder predictivo
Una alta correlación (positiva o negativa) entre una variable explicativa y la variable a predecir sugiere que los cambios en esa variable tienen impacto directo y proporcional sobre el valor que queremos estimar.
Ejemplo en el dataset Auto MPG:
- Si displacement (El desplazamiento) se correlaciona fuertemente con horsepower (caballos de vapor), esa variable es útil para el modelo porque a más desplazamiento, mayores caballos de vapor, lo que es coherente y aprovechable por la regresión.
Para estimar el coeficiente de un modelo de regresión múltiple, se puede usar:
- Descenso del Gradiente en scikit-learn mediante la función LinearRegressionGD()
- Mínimos Cuadrados Ordinarios (MCO) en scikit-learn LinearRegression()
¿Qué diferencia existe entre usar Descenso del Gradiente y Mínimos Cuadrados Ordinarios?
Vamos a ver la diferencia entre LinearRegressionGD() y LinearRegression(), ya que aunque ambas sirven para entrenar modelos de regresión lineal, utilizan métodos distintos para encontrar los coeficientes del modelo.
Ejemplo comparativo rápido:
| Característica | LinearRegression() | LinearRegressionGD() |
| Método de cálculo | Mínimos cuadrados (analítico) | Descenso del gradiente (iterativo) |
| Precisión | Alta | Depende de los hiperparámetros |
| Velocidad en datasets pequeños | Muy rápida | Más lenta |
| Requiere tuning | No | Sí (learning rate, iteraciones) |
| Escalabilidad | Media | Alta |
¿Cuál vamos a usar?
- LinearRegression() si estamos empezando o trabajamos con datasets pequeños/medianos.
- O LinearRegressionGD() si estamos experimentando, aprendiendo el algoritmo desde cero o trabajando con Big Data donde no es viable resolver ecuaciones analíticas.
Descenso del gradiente
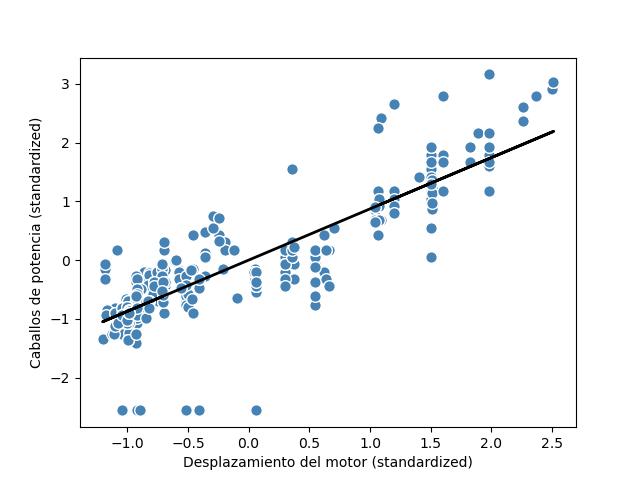
El código siguiente implementa la regresión lineal por descenso de gradiente para predecir el los caballos de potencia (horsepower) de un vehículo en función del desplazamiento en el motor(displacement). Incluye funciones para cargar datos, normalizar, entrenar el modelo de regresión lineal, visualizar la convergencia de la función de coste, trazar la línea de regresión e invertir la normalización para realizar predicciones.
import pandas as pd
from sklearn import datasets
import numpy as np
from sklearn.preprocessing import StandardScaler
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.preprocessing import StandardScaler
class LinearRegressionGD(object):
    def __init__(self, eta=0.001, n_iter=20):
        self.eta = eta
        self.n_iter = n_iter
    def fit(self, X, y):
        self.w_ = np.zeros(1 + X.shape[1])
        self.cost_ = []
        for i in range(self.n_iter):
            output = self.net_input(X)
            errors = (y - output)
            self.w_[1:] += self.eta * X.T.dot(errors)
            self.w_[0] += self.eta * errors.sum()
            cost = (errors**2).sum() / 2.0
            self.cost_.append(cost)
        return self

    def net_input(self, X):
        return np.dot(X, self.w_[1:]) + self.w_[0]

    def predict(self, X):
        return self.net_input(X)

def leerDatos():
    datos = pd.read_csv('RegresionLineal/auto-mpg.csv',encoding='utf-8')
    #Leemos todos los datos menos la ultima columna
    datos = datos.iloc[:, :-1]
    # Convertir todos los datos en enteros en flotantes
    datos = datos.astype('float', errors='ignore')
    datos.columns = ['mpg','cylinders','displacement','horsepower','weight','acceleration','model year','origin']
    datos.head()
    X = datos[['displacement']].values
    y = datos['horsepower'].values
    return X,y

def normalizacion(X,y):
    sc_x = StandardScaler()
    sc_y = StandardScaler()
    X_std = sc_x.fit_transform(X)
    y_std = sc_y.fit_transform(y[:, np.newaxis]).flatten()
    return X_std,y_std,sc_x,sc_y
def invertirNormalizacion(X,y,sc_x,sc_y):
    desplazamiento_sd =np.array([[2.0]])
    potencia_std = lr.predict(np.array(desplazamiento_sd)) #Predice la potencia
    print("Desplazamiento normalizado: %.3f" % desplazamiento_sd)
    print("Potencia normalizada: %.3f" % potencia_std)

    desplazamiento = sc_x.inverse_transform(desplazamiento_sd)
    print("Desplazamiento: %.3f" % desplazamiento)
    print("Potencia: %.3f" % sc_y.inverse_transform(np.array([potencia_std])))


def lin_regplot(X, y, model):
    plt.scatter(X, y, c='steelblue', edgecolor='white', s=70)
    plt.plot(X, model.predict(X), color='black', lw=2)
    return
def mostrarGraficoCostes(lr):
    plt.plot(range(1, lr.n_iter+1), lr.cost_)
    plt.ylabel('SSE')
    plt.xlabel('Epoch')
    #plt.tight_layout()
    #plt.savefig('images/10_05.png', dpi=300)
    plt.show()
def mostrarRectaRegresionLineal(X_std,y_std,lr):
    lin_regplot(X_std, y_std, lr)
    plt.xlabel('Desplazamiento del motor (standardized)')
    plt.ylabel('Caballos de potencia (standardized)')
    #plt.savefig('images/10_06.png', dpi=300)
    plt.show()
X,y = leerDatos()
X_std,y_std,sc_x,sc_y= normalizacion(X,y)
lr = LinearRegressionGD()
lr.fit(X_std, y_std)
mostrarGraficoCostes(lr)
mostrarRectaRegresionLineal(X_std,y_std,lr)
invertirNormalizacion(X,y,sc_x,sc_y)

Mínimos Cuadrados Ordinarios (MCO) de scikit-learn
En el siguiente código:
- Leemos un archivo CSV llamado auto-mpg.csv que contiene datos de automóviles.
- Extraemos dos columnas:
- displacement (desplazamiento del motor) como variable independiente (X).
- horsepower (caballos de fuerza) como variable dependiente (y).
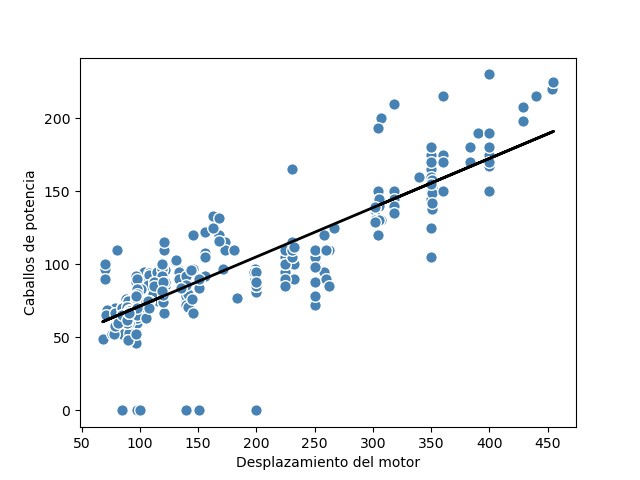
- Entrenamos un modelo de regresión lineal usando scikit-learn para predecir la potencia (horsepower) a partir del desplazamiento (displacement).
- Mostramos un gráfico con:
- Un diagrama de dispersión de los datos reales.
- Una línea negra representando la predicción del modelo (regresión lineal).
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
def leerDatos():
    datos = pd.read_csv('RegresionLineal/auto-mpg.csv',encoding='utf-8')
    #Leemos todos los datos menos la ultima columna
    datos = datos.iloc[:, :-1]
    # Convertir todos los datos en enteros en flotantes
    datos = datos.astype('float', errors='ignore')
    datos.columns = ['mpg','cylinders','displacement','horsepower','weight','acceleration','model year','origin']
    datos.head()
    X = datos[['displacement']].values
    y = datos['horsepower'].values
    return X,y
def mostrarRegresionLineal(X,y,lr):
    plt.scatter(X, y, c='steelblue', edgecolor='white', s=70)
    plt.plot(X, lr.predict(X), color='black', lw=2)
    plt.xlabel('Desplazamiento del motor')
    plt.ylabel('Caballos de potencia')
    #plt.savefig('images/10_06.png', dpi=300)
    plt.show()
X,y = leerDatos()
lr = LinearRegression()
lr.fit(X, y)
mostrarRegresionLineal(X,y,lr)
print("Coeficientes:", lr.coef_)
Coeficientes: [0.33674277]
Ejemplo de la regresión lineal con Python usando los Mínimos Cuadrados Ordinarios
Aquí tenemos otro ejemplo sencillo de código para aplicar regresión lineal de tres variables con scikit-learn:
- Leemos un archivo CSV llamado auto-mpg.csv que contiene datos de automóviles.
- Asignamos nombres a las columnas y limpiamos los datos faltantes
- Seleccionamos múltiples variables independientes:
-
- horsepower, weight, acceleration
- La variable a predecir (y) es el consumo en millas por galón (mpg).
- Dividimos los datos en conjunto de entrenamiento y prueba (80% entrenamiento, 20% prueba).
- Entrenamos un modelo de regresión lineal con LinearRegression().
- Hacemos predicciones sobre el conjunto de prueba.
- Calculamos y nuestramos el error cuadrático medio (MSE) y los coeficientes del modelo.
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error
def leerDatos():
    datos = pd.read_csv('RegresionLineal/auto-mpg.csv',encoding='utf-8')
    #Leemos todos los datos menos la ultima columna
    datos = datos.iloc[:, :-1]
    # Convertir todos los datos en enteros en flotantes
    datos = datos.astype('float', errors='ignore')
    datos.columns = ['mpg','cylinders','displacement','horsepower','weight','acceleration','model year','origin']
    datos.head()
    return datos

def limpiarDatos(data):
    # Limpieza básica
    data = data.dropna() #Elimina todas las filas que tienen valores nulos (NaN)
    return data
def getSeparacionDatos(datos_limpios):
    # Separar variables independientes y dependiente
    X = datos_limpios[["horsepower", "weight", "acceleration"]]
    y = datos_limpios["mpg"]
    return X,y
datos = leerDatos();
datos_limpios=limpiarDatos(datos)
X,y = getSeparacionDatos(datos_limpios)


# Dividimos en entrenamiento y prueba
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# Modelo de regresión lineal
modelo = LinearRegression()
modelo.fit(X_train, y_train)

# Predicciones
predicciones = modelo.predict(X_test)
error = mean_squared_error(y_test, predicciones)
print("Error cuadrático medio:", error)
print("Coeficientes:", modelo.coef_)
Error cuadrático medio: 15.035236091395324
Coeficientes: [-0.04096137 -0.00619314  0.02010965]
Conceptos clave que aprendemos con regresión lineal con auto mpg
- Cómo ver las relaciones entre variables
- Visualizar las características del conjunto de datos Dataset Auto-MPG mediante la matriz de dispersión.
- Observar las relaciones del conjunto de datos Dataset Auto-MPG mediante la matriz de correlación.
- Por qué se escoge la variable con mayor correlación lineal para la regresión.
- Diferencia que existe entre usar Descenso del Gradiente y Mínimos Cuadrados Ordinarios
- Ejemplos del descenso del gradiente, Mínimos Cuadrados Ordinarios y otro con tres variables usando los Mínimos Cuadrados Ordinarios