Redes de convolucion

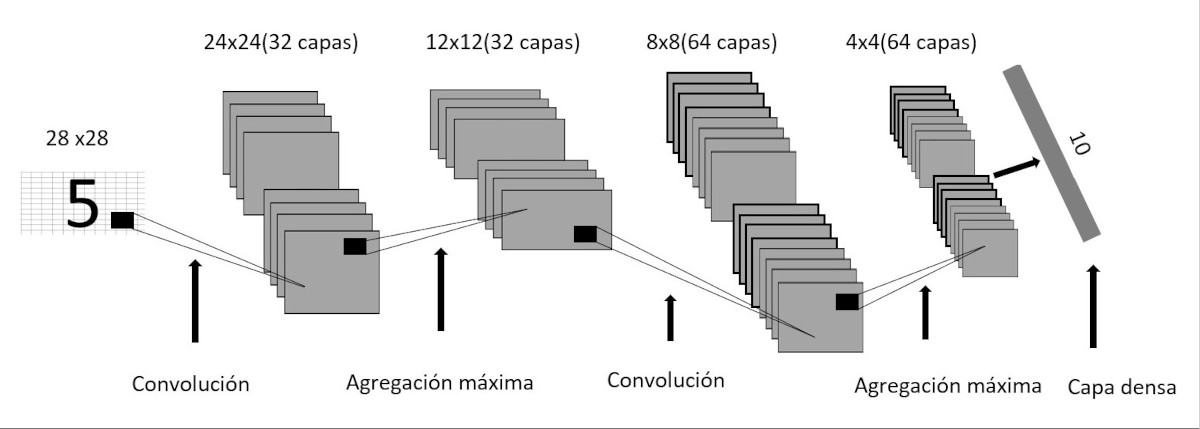
Esquema de las redes de convolucion con secuencias de convolucion y pooling

Las redes de convolucion o redes neuronales convolucionales (CNN) son un tipo de arquitectura de aprendizaje profundo especialmente diseñada para procesar datos con estructura espacial o temporal, como imágenes, señales de audio y series temporales.

Estas redes están formadas por capas de convolución, que extraen características locales del dato, y capas de agrupación o pooling, que reducen la dimensionalidad y mejoran la eficiencia del modelo. Finalmente, las CNN incluyen capas densas o totalmente conectadas, encargadas de realizar la clasificación o regresión final, según el objetivo del modelo.

Diferencias entre redes de capas densas y de convolucion

Si las redes neuronales de capas densas están compuestas por capas completamente conectadas, donde cada neurona de una capa está conectada a todas las neuronas de la capa siguiente en las redes de convolucion las neuronas están conectadas localmente a regiones específicas de la entrada mediante filtros de convolución.

La capas densas aprenden patrones globales mientras que en las redes de convolucion aprenden patrones locales dentro de la imagen en pequeñas ventanas de 2 dimensiones.

En las redes de convolución una vez que aprenden una característica en un punto concreto de la imagen, esta puede ser reconocida en cualquier otra parte, en cambio en las redes densamente conectadas tienen que volver a aprender nuevamente la característica si este aparece en otro sitio de la imagen.

Como funcionan las redes de convolucion

Las redes neuronales convolucionales (o redes de convolución) funcionan aplicando filtros de convolución a lo largo de sus capas para extraer características importantes de los datos, especialmente en imágenes. Estas redes están compuestas por varias capas especializadas que procesan la información paso a paso:

Capas de convolución

Las capas convolucionales extraen características locales relevantes mediante filtros o kernels, que son matrices de pesos. Estos filtros se deslizan sobre la imagen (de izquierda a derecha y de arriba hacia abajo), detectando bordes, formas y texturas, y generando mapas de características que representan la información aprendida.

Función de activación

Después de cada operación de convolución, se aplica una función de activación no lineal como ReLU (Rectified Linear Unit). Esta función introduce no linealidades al modelo, devolviendo el valor si es positivo y cero si es negativo, permitiendo que la red aprenda patrones complejos.

Capas de agrupación (pooling)

Las capas de agrupación, como el max pooling o el average pooling, reducen la dimensionalidad de los mapas de características. Esto mejora la eficiencia del modelo y ayuda a evitar el sobreajuste al conservar solo la información más relevante.

Capa densa o completamente conectada

Tras las capas convolucionales y de agrupación, los mapas de características se aplanan y se envían a una capa densa (fully connected) que realiza la clasificación final. Esta etapa integra la información extraída y predice la clase correspondiente según la tarea del modelo.

Para que sirven las redes de convolucion

  • Para clasificar de imágenes
  • Detectar objetos
  • Segmentar imágenes
  • Reconocimiento facial
  • Clasificación de texto en imágenes
from keras.models import Sequential
from keras.layers import Conv2D, MaxPooling2D,Dense,Flatten
import keras.datasets.mnist as mnist
import numpy as np
from sklearn.metrics import confusion_matrix
from keras.utils import to_categorical
def getDatos():
   (x_train, y_train) , (x_test, y_test)= mnist.load_data()   
   return x_train, y_train,x_test, y_test

Cargamos los datos del conjunto de datos MNIST de los datasets de Keras de la siguiente forma:

El código (x_train, y_train), (x_test, y_test) = mnist.load_data() cargamos el conjunto de datos MNIST, que es un conjunto de imágenes de dígitos escritos a mano, junto con sus etiquetas correspondientes:

  • x_train: Contiene las 6000 imágenes de entrenamiento, representadas como matrices de píxeles de 28 x 28. Cada imagen representa un dígito escrito a mano.
  • y_train: Contiene las etiquetas de entrenamiento del 0 al 9, que indican el dígito correspondiente a cada imagen en x_train.
  • x_test: Contiene las 1000 imágenes de test, representadas como matrices de píxeles de 28 x 28. Cada imagen representa un dígito escrito a mano.
  • y_test: Contiene las etiquetas de test del 0 al 9, que indican el dígito correspondiente a cada imagen en x_test..

Un tensor x_train se compone de 3 dimensiones de (6000,28,28) y de tipo uint8 con valores entre 0 y 255.

Normalizamos los datos, convertimos cada imagen de 28×28, en tres dimensiones para que cada imagen tenga la forma de (28,28,1). Esto lo hacemos para que coincida con la entrada esperada por la red neuronal convolucional. Las dimensiones (28, 28) representan el tamaño de la imagen, mientras que 1 indica que la imagen es en escala de grises:

def normalizar(x_train,x_test):
    x_train = x_train.reshape((60000,28,28,1))
    x_train = x_train.astype('float32') /255
    x_test = x_test.reshape((10000,28,28,1))
    x_test = x_test.astype('float32') /255
    return x_train,x_test

Codificamos las etiquetas en codificación one-hot donde se transforman las etiquetas en un vector que tiene la longitud de 10 etiquetas y el valor 1 en el índice correspondiente al valor de la etiqueta:

def codificacionEtiquetas(y_train,y_test):
    #Codificamos las salidas en formato en codificacion one-hot
    y_train = to_categorical(y_train)
    y_test =  to_categorical(y_test)
    return y_train,y_test  

Primeramente vamos a crear un modelo secuencial, seguido de una primera capa de convolución con 32 filtros, cada rejilla de tamaño (5, 5) y una función de activación ReLU, con la forma de entrada en (28, 28, 1).

Después agregamos una capa de agrupación máxima que reduce la dimensionalidad de las características convolucionales seleccionando el valor máximo en una región de tamaño (2,2).

Seguidamente agregamos una segunda capa de convolución al modelo con 64 filtros función de activación ReLU.

Después otra capa de agrupación máxima de 2×2 después de la segunda capa de convolución para reducir aún más la dimensionalidad.

Con la capa de aplanamiento Flatten convertimos las características convolucionales 2D en un vector unidimensional, para alimentar a la capa densa.

Finalmente agregamos una capa densa final con 10 neuronas, una para cada clase en el conjunto de datos MNIST donde la función de activación utilizada es softmax, generando probabilidades para cada clase.

def getModelo():
    # Definimos el modelo
    modelo = Sequential()
    # Primera capa de convolución
    modelo.add(Conv2D(32, (5, 5), activation='relu', input_shape=(28, 28, 1)))
    modelo.add(MaxPooling2D((2,2)))    
    # Segunda capa de convolución
    modelo.add(Conv2D(64, (5, 5), activation='relu'))
    modelo.add(MaxPooling2D((2,2)))    
    modelo.add(Flatten())
    modelo.add(Dense(10, activation='softmax')) 
    modelo.sumary()
    return modelo

Para configurar el proceso de aprendizaje configuramos la función de pérdida (loss) como ‘categorical_crossentropy’, el optimizador como ‘sgd’ (descenso de gradiente estocástico) y la métrica para evaluar el rendimiento del modelo durante el entrenamiento como ‘accuracy’ (exactitud).

def compilarModelo(modelo):
    modelo.compile(loss='categorical_crossentropy', optimizer='sgd',metrics=['accuracy'])
    return modelo

Entrenamos el modelo con un lote de 100 muestras, en 10 épocas y mostrando información sobre el progreso del entrenamiento en la pantalla:

def fit(modelo,x_train, y_train):
    modelo.fit(x_train, y_train,batch_size=100,epochs=5,verbose=1)
    return modelo

Con verbose=1 informamos por pantalla de la evolución del entrenamiento

Model: "sequential"
_________________________________________________________________
 Layer (type)                Output Shape              Param #
=================================================================
 conv2d (Conv2D)             (None, 24, 24, 32)        832

 max_pooling2d (MaxPooling2  (None, 12, 12, 32)        0
 D)

 conv2d_1 (Conv2D)           (None, 8, 8, 64)          51264

 max_pooling2d_1 (MaxPoolin  (None, 4, 4, 64)          0
 g2D)

 flatten (Flatten)           (None, 1024)              0

 dense (Dense)               (None, 10)                10250

=================================================================
Total params: 62346 (243.54 KB)
Trainable params: 62346 (243.54 KB)
Non-trainable params: 0 (0.00 Byte)
___________________________________

En la primera capa de convolución tenemos una rejilla de 5 x 5 con 25 parámetros y le añadimos el sesgo b que hacen 26 parámetros que multiplicado por las 32 capas se tienen que ajustar (25+1) * 32= 832 parámetros.

En la segunda capa de convolución tenemos una rejilla de 5 x 5 con 25 parámetros multiplicado por las 64 capas más el sesgo b=1 se tienen que ajustar (25 x 32) + 1 * 64 = 51264 parámetros.

El sesgo (bias) en una capa de convolución se agrega después de aplicar la operación de convolución a los datos de entrada.

En cuanto a los tensores:

  • Tenemos un tensor de entrada de (28,28,1).
  • Hacemos la primera de capa de convolución y generamos un tensor de salida de (24,24,32).
  • Se debe a que la convolución reduce la altura y el ancho de la imagen en 4 píxeles en cada dimensión (28 – 5 + 1 = 24) y la profundidad es de 32 debido a los 32 filtros aplicados.
  • En el pooling de la primera capa generamos un tensor de (12,12,32) y en la segunda de capa de convolución generamos un tensor de salida de (8,8,64).
  • Esto es debido a que nuevamente la convolución reduce la altura y el ancho de la imagen (12 – 5 + 1 = 8) y la profundidad es de 64 debido a los 64 filtros aplicados.
  • Para pooling de la segunda capa generamos un tensor de (4,4,64) y en la capa flatten su salida tendremos un tensor de 1024.
  • En la capa de salida el tensor de salida es 10

Generamos las predicciones mediante la siguiente instrucción:

def getPredicciones(modelo,x_test):
    prediciones = modelo.predict(x_test)
    return prediciones

Evaluamos el modelo de la siguiente manera:

def evaluarModelo(modelo,x_test, y_test):
    test_loss, test_acc = modelo.evaluate(x_test, y_test)
    print('Test loss:', test_loss)
    print('Test accuracy:', test_acc) 
Test loss: 0.10029333084821701
Test accuracy: 0.9693999886512756

Matriz de confusión

prediciones = modelo.predict(x_test)
y_predic = np.argmax(predictions, axis=1)
y_test_b = np.argmax(y_test, axis=1)
print(confusion_matrix(y_test_b,y_predic))

Matriz de confusión:

[[ 966    0    1    0    1    2    5    2    3    0]
 [   0 1123    2    1    0    0    2    0    7    0]
 [   4    2  995    4    6    0    4    6    9    2]
 [   1    0    3  976    0    6    0    8    9    7]
 [   1    0    2    0  954    0    4    1    4   16]
 [   2    1    1   13    0  860    6    1    6    2]
 [   6    4    1    1    5    6  933    0    2    0]
 [   1    7   19    4    0    0    0  979    2   16]
 [   7    1    1    8    4    3    4    8  929    9]
 [   4    7    0    7    5    4    1    4    3  974]]

Codigo de ejemplo

from keras.models import Sequential
from keras.layers import Conv2D, MaxPooling2D,Dense,Flatten
import keras.datasets.mnist as mnist
import numpy as np
from sklearn.metrics import confusion_matrix
from keras.utils import to_categorical
def getDatos():
   (x_train, y_train) , (x_test, y_test)= mnist.load_data()   
   return x_train, y_train,x_test, y_test
def normalizar(x_train,x_test):
    x_train = x_train.reshape((60000,28,28,1))
    x_train = x_train.astype('float32') /255
    x_test = x_test.reshape((10000,28,28,1))
    x_test = x_test.astype('float32') /255
    return x_train,x_test
def codificacionEtiquetas(y_train,y_test):
    #Codificamos las salidas en formato en codificacion one-hot
    y_train = to_categorical(y_train)
    y_test =  to_categorical(y_test)
    return y_train,y_test
    
def getModelo():
    # Definimos el modelo
    modelo = Sequential()
    # Primera capa de convolución
    modelo.add(Conv2D(32, (5, 5), activation='relu', input_shape=(28, 28, 1)))
    modelo.add(MaxPooling2D((2,2)))    
    # Segunda capa de convolución
    modelo.add(Conv2D(64, (5, 5), activation='relu'))
    modelo.add(MaxPooling2D((2,2)))    
    modelo.add(Flatten())
    modelo.add(Dense(10, activation='softmax')) 
    modelo.summary()
    return modelo
def compilarModelo(modelo):
    modelo.compile(loss='categorical_crossentropy', optimizer='sgd',metrics=['accuracy'])
    return modelo
def fit(modelo,x_train, y_train):
    modelo.fit(x_train, y_train,batch_size=100,epochs=5,verbose=1)
    return modelo
def evaluarModelo(modelo,x_test, y_test):
    test_loss, test_acc = modelo.evaluate(x_test, y_test)
    print('Test loss:', test_loss)
    print('Test accuracy:', test_acc) 
def getPredicciones(modelo,x_test):
    prediciones = modelo.predict(x_test)
    return prediciones
x_train, y_train,x_test, y_test = getDatos()
x_train,x_test, = normalizar(x_train,x_test)
y_train,y_test=codificacionEtiquetas(y_train,y_test)
modelo = getModelo()
modelo = compilarModelo(modelo)
modelo = fit(modelo,x_train, y_train)
evaluarModelo(modelo,x_test, y_test)
prediciones=getPredicciones(modelo,x_test)
y_predic = np.argmax(prediciones, axis=1)
y_test_b = np.argmax(y_test, axis=1)
print(confusion_matrix(y_test_b,y_predic))