

Que es DBSCAN
DBSCAN es un algoritmo de agrupamiento espacial basado en la densidad de puntos. A diferencia de métodos tradicionales como K-means, DBSCAN no requiere definir previamente el número de clústeres y permite detectar grupos de forma arbitraria dentro del espacio de características. Esta flexibilidad lo convierte en una opción eficaz para identificar patrones complejos en los datos.
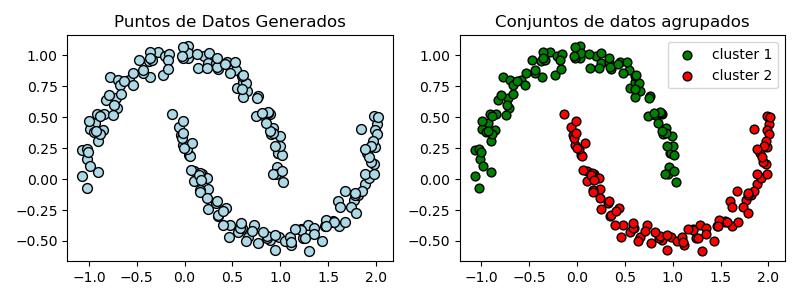
Que características tiene DBSCAN
El algoritmo DBSCAN se caracteriza por su capacidad para identificar clústeres basados en la densidad de puntos dentro de un conjunto de datos. A continuación, se describen sus propiedades esenciales:
-
Densidad: DBSCAN define un clúster como una región densa de puntos separada por zonas de menor densidad. Esta densidad se calcula en función del número de puntos dentro de un radio específico alrededor de cada observación.
-
Conectividad: Este algoritmo puede agrupar puntos densamente conectados, lo que le permite detectar clústeres de formas y tamaños arbitrarios, adaptándose mejor que otros métodos a datos no lineales o complejos.
-
Regiones densas: Las regiones de alta densidad son áreas donde la concentración de puntos es mucho mayor que en el resto del espacio de datos. Identificar estas regiones es fundamental para encontrar clústeres que reflejan estructuras naturales en los datos.
-
Ejemplo visual: En un conjunto de datos bidimensional, las regiones densas aparecen como zonas con alta concentración de puntos. Estas zonas indican la presencia de clústeres o patrones relevantes, mientras que las áreas más dispersas pueden considerarse como ruido o datos atípicos.
Agrupa los datos basándose en la densidad. Encuentra regiones de alta densidad separadas por regiones de baja densidad y va asignando a los puntos en el borde a los clústeres en función de su conectividad, además no requiere especificar el número de clústeres de antemano y puede detectar automáticamente el número de clústeres en función de la densidad de los datos.
En DBSCAN los puntos son las muestras del conjunto de datos que se están agrupando. Cada punto tiene coordenadas en un espacio de características y puede estar rodeado por otros puntos dentro de un radio específico, determinados por el parámetro de radioeps.
Los puntos en DBSCAN pueden tener diferentes roles asignandose una etiqueta especial a cada muestra mediante los siguientes criterios:
- Núcleos: Son los puntos que tienen al menos un número mínimo de puntos dentro de un radio eps especificado, incluido él mismo. Los núcleos son la base de los clusters.
- Puntos frontera: Son puntos que no son núcleos pero están dentro del radio eps de un núcleo. Estos puntos se asignan al mismo cluster que su núcleo correspondiente.
- Puntos de ruido: Son puntos que no son núcleos ni están dentro del radio eps de ningún núcleo. En otras palabras, no pueden ser asignados a ningún cluster y se consideran como ruido en el conjunto de datos.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_moons
from sklearn.cluster import DBSCAN
def getDatos():
    X, _ = make_moons(n_samples=200, noise=0.05, random_state=0)
    return X
def grafico(X,y_db):
    f, (ax1, ax2) = plt.subplots(1, 2, figsize=(8, 3))
    ax1.scatter(X[:, 0], X[:, 1], s=50,c='lightblue', marker='o',
                edgecolor='black')
    ax1.set_title('Puntos de Datos Generados')
    ax2.scatter(X[y_db == 0, 0], X[y_db == 0, 1],
                c='green', marker='o', s=40,
                edgecolor='black',
                label='cluster 1')
    ax2.scatter(X[y_db == 1, 0], X[y_db == 1, 1],
                c='red', marker='o', s=40,
                edgecolor='black',
                label='cluster 2')
    ax2.set_title('Conjuntos de datos agrupados')
    ax2.legend(scatterpoints=1)
    plt.legend()
    plt.tight_layout()
    plt.show()
X=getDatos()
#Creamos un objeto DBSCAN con un radio de vecindad de 0.2, con al menos 5 muestras en la vecindad
#y distancia euclidiana
db = DBSCAN(eps=0.2, min_samples=5, metric='euclidean')
y_db = db.fit_predict(X)
grafico(X,y_db)


