
Hiperparámetros de una red neuronal
Introducción a los hiperparametros de una red neuronal
Los hiperparametros de una red neuronal y los parámetros son dos conceptos fundamentales en el diseño y entrenamiento de redes neuronales. Comprender su función es esencial para desarrollar modelos eficientes y precisos.
Los hiperparametros de una red neuronal son variables que no se aprenden directamente durante el proceso de entrenamiento del modelo. Se definen antes de entrenar la red y afectan directamente la manera en que se entrena el modelo.
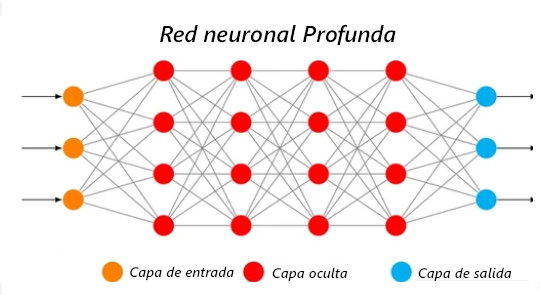
Por otro lado, los parámetros de una red neuronal son los valores que el algoritmo ajusta durante el proceso de entrenamiento con el objetivo de minimizar la función de pérdida y mejorar la precisión de las predicciones. Estos parámetros representan las conexiones ponderadas entre las neuronas y determinan cómo se transforman y propagan los datos dentro de la red neuronal.
Parámetros
Los parámetros más importantes de un modelo neuronal incluyen:
- Pesos: Los pesos son parámetros que determinan la influencia de las entradas en las salidas de una neurona. Representan la intensidad de la conexión entre dos neuronas y son fundamentales en el aprendizaje automático.
- Sesgos: El sesgo (o bias) es un valor constante que se suma a la entrada ponderada de una neurona antes de aplicar la función de activación. Permite que la neurona se active incluso sin una entrada significativa, y ajusta la sensibilidad general del modelo a los datos.
Inicialización de los pesos de los parámetros
Existen distintas estrategias para inicializar los pesos de los parámetros de una red neuronal:
Inicialización aleatoria
Consiste en asignar valores pequeños aleatorios a los pesos, lo que evita que todas las neuronas de una misma capa aprendan los mismos patrones simultáneamente.
rgen = np.random.RandomState(1)
W = rgen.normal(loc=0.0, scale=0.01, size=X.shape[1])
Este código inicializa una matriz de pesos aleatorios usando una distribución normal con media cero y varianza baja. Es una práctica común antes de entrenar una red neuronal.
En bibliotecas como Keras, los pesos se inicializan automáticamente al añadir capas al modelo y compilarlo, utilizando esquemas predefinidos. Esto permite que el modelo comience a aprender de manera simétrica desde cero.
Ajuste de los parámetros durante el proceso de entrenamiento para minimizar la función de pérdida
Durante el entrenamiento de una red neuronal, las entradas se propagan hacia adelante para generar una predicción. Luego se calcula el error (función de pérdida) entre las predicciones y las etiquetas reales. A continuación, se retropropaga este error para calcular los gradientes y ajustar los parámetros con algoritmos como SGD, Adam o RMSProp, junto con la tasa de aprendizaje. Este proceso se repite durante varias épocas, hasta que la pérdida se minimiza o se cumple un criterio de parada.
Hiperparametros de una red neuronal
Los hiperparámetros pueden clasificarse en dos grandes grupos:
- Estructurales: Número de neuronas por capa, cantidad de capas, funciones de activación, inicialización de pesos, etc.
- De aprendizaje: Epochs, learning rate, momentum, batch size, entre otros.
Diferencias entre los hiperparametros de una red neuronal
- Epochs: Número de veces que el modelo recorre todo el conjunto de entrenamiento.
- Momentum: Acelera la convergencia y ayuda a evitar mínimos locales.
- Learning rate: Controla la magnitud de los cambios aplicados a los pesos.
- Learning rate decay: Disminuye gradualmente el learning rate durante el entrenamiento, mejorando la precisión.
- Batch size: Cantidad de muestras usadas para calcular el gradiente y actualizar los pesos.
Hiperparámetros antes de entrenar una red neuronal
Antes de iniciar el entrenamiento, es necesario definir los siguientes hiperparámetros clave:
- Número de capas: Cantidad total de capas del modelo.
- Tamaño de la capa oculta: Número de neuronas por capa.
- Funciones de activación: ReLU, Sigmoid, Tanh, Softmax, etc.
- Tasa de aprendizaje: Influye en la rapidez del aprendizaje.
- Tasa de regularización: Ayuda a prevenir el sobreajuste.
- Función de pérdida: Determina cómo se mide el error (para clasificación binaria, regresión, etc.).
- Algoritmo de optimización: Método utilizado para actualizar los pesos.
- Batch size: Número de ejemplos usados por iteración.
Cómo elegir los hiperparámetros más adecuados para un problema específico
- Búsqueda manual: Prueba y error ajustando hiperparámetros uno a uno.
- Búsqueda por rejilla (Grid Search): Evalúa combinaciones específicas de hiperparámetros.
- Búsqueda aleatoria: Selecciona combinaciones al azar dentro de un rango definido.
- Optimización bayesiana: Modela el rendimiento para hacer búsquedas más eficientes.
Hiperparámetros que tienen mayor impacto en el rendimiento y la generalización
- Número de capas y neuronas
- Learning rate
- Regularización
- Batch size
- Función de activación
Regularización y prevención del sobreajuste
Algunas estrategias para evitar el sobreajuste en redes neuronales incluyen:
- Regularización L1 y L2: Penalizan valores grandes de los pesos.
- Dropout: Desactiva aleatoriamente neuronas durante el entrenamiento.
- Early Stopping: Detiene el entrenamiento si no mejora la pérdida en el conjunto de validación.
- BatchNormalization: Normaliza las activaciones de las capas para mejorar la estabilidad.
- Weight Decay: Agrega una penalización por pesos grandes en la función de pérdida.
Conclusión
Comprender y ajustar correctamente los hiperparámetros de una red neuronal es fundamental para alcanzar un buen rendimiento. Una combinación adecuada permite entrenar modelos eficientes, evitar el sobreajuste y mejorar la capacidad de generalización.