


¿Qué es el escalado de características?
El escalado de características es un proceso clave en el preprocesamiento de datos para Machine Learning. Consiste en ajustar los valores de las variables para que estén dentro de un rango definido. Esto mejora el rendimiento de los modelos y reduce el coste computacional, especialmente en algoritmos que utilizan distancias (como k-NN o SVM) o el descenso por gradiente.
Cuando los datos tienen escalas diferentes, las variables con valores mayores pueden dominar a las otras, afectando negativamente los resultados. Para resolverlo, existen dos técnicas principales: normalización y estandarización de datos en Python.
¿Por qué es importante escalar los datos?
- Evita que variables con diferentes escalas dominen el modelo.
- Mejora la velocidad de convergencia en algoritmos de optimización.
- Hace que las métricas de distancia (como en k-NN o clustering) sean más fiables.
- Reduce el riesgo de sesgo en los resultados del modelo.
Técnicas comunes de escalado
Normalización (Min-Max Scaling)
La normalización (también conocida como Min-Max Scaling) transforma los valores de una variable para que estén en el rango [0, 1].
Fórmula:
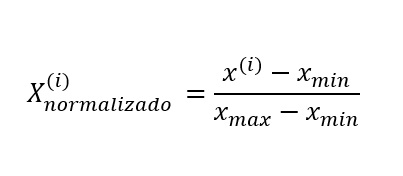
Útil cuando no se asume una distribución gaussiana y los datos deben conservar su forma.
Estandarización (Z-Score Scaling)
La estandarización ajusta los datos para que tengan media 0 y desviación estándar 1. Es ideal cuando los datos no están acotados y se distribuyen normalmente.
Fórmula:
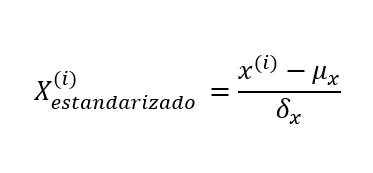
Recomendado cuando los datos siguen una distribución normal o cuando se usan modelos lineales.
Ejemplo 1: Escalado manual con NumPy
El siguiente ejemplo en Python muestra cómo aplicar escalado de características utilizando las librerías NumPy y Scikit-learn. Primero, se crea un arreglo de datos y se reestructura para ajustarse al formato requerido por los transformadores de Scikit-learn. Luego, se aplica la normalización con MinMaxScaler, que escala los valores al rango [0, 1], y la estandarización con StandardScaler, que ajusta los datos a una media de 0 y desviación estándar de 1. Este tipo de preprocesamiento es clave para mejorar el rendimiento de modelos de machine learning. Escalar correctamente tus datos garantiza resultados más precisos y estables.
import numpy as np
datos = np.array([1,2,3,4,5,6])
print('Estandarizacion: ',(datos - datos.mean())/datos.std())
print('Normalizacion: ',(datos - datos.min())/(datos.max() - datos.min()))
Salida:
Estandarización: [-1.46 -0.87 -0.29 0.29 0.87 1.46]
Normalización: [0. 0.2 0.4 0.6 0.8 1. ]
Este código demuestra cómo aplicar manualmente ambas técnicas usando solo NumPy.
Ejemplo 2: Escalado con Scikit-learn
El siguiente código utiliza las bibliotecas Numpy y Scikit-Learn para realizar la estandarización y la normalización de los datos. Los datos se transforman primero en una matriz de una sola columna, luego se crean objetos para realizar la estandarización y la normalización. Donde esos objetos se entrenan con un transformador o estimador en función de los datos proporcionados y, al mismo tiempo, aplican la transformación a esos datos
import numpy as np
from sklearn.preprocessing import StandardScaler
from sklearn.preprocessing import MinMaxScaler
datos = np.array([1,2,3,4,5,6])
datos = datos.reshape(-1,1)
estandarizacion=StandardScaler()
normalizacion=MinMaxScaler()
datos_estandarizados = estandarizacion.fit_transform(datos)
datos_normalizados = normalizacion.fit_transform(datos)
print(‘Datos normalizados: ‘)
print(datos_normalizados)
print()
print(‘Datos estandarizados: ‘)
print(datos_estandarizados)
Resultado esperado:
Datos normalizados:
[[0. ] [0.2] [0.4] [0.6] [0.8] [1. ]]
Datos estandarizados:
[[-1.46] [-0.87] [-0.29] [0.29] [0.87] [1.46]]
Este ejemplo usa StandardScaler y MinMaxScaler de Scikit-learn para automatizar el proceso.
¿Cuándo usar normalización o estandarización?
| Situación | Técnica recomendada |
| Datos no distribuidos normalmente | Normalización |
| Datos con outliers | Estandarización |
| Modelos basados en distancia (KNN, SVM, PCA) | Ambas pueden ser útiles |
| Modelos lineales (regresión, clasificación) | Estandarización |
Conclusión
La normalización de datos en Python es esencial para entrenar modelos de Machine Learning de forma efectiva. Elegir entre normalización o estandarización dependerá de la naturaleza del modelo y los datos. Herramientas como NumPy y Scikit-learn hacen que este proceso sea sencillo, eficiente y reproducible.
Recomendación
Utiliza estas técnicas de escalado en todos tus proyectos de clasificación o regresión para mejorar la precisión del modelo y reducir el tiempo de entrenamiento.


