

Que es Data augmentation
Introducción a Data augmentation
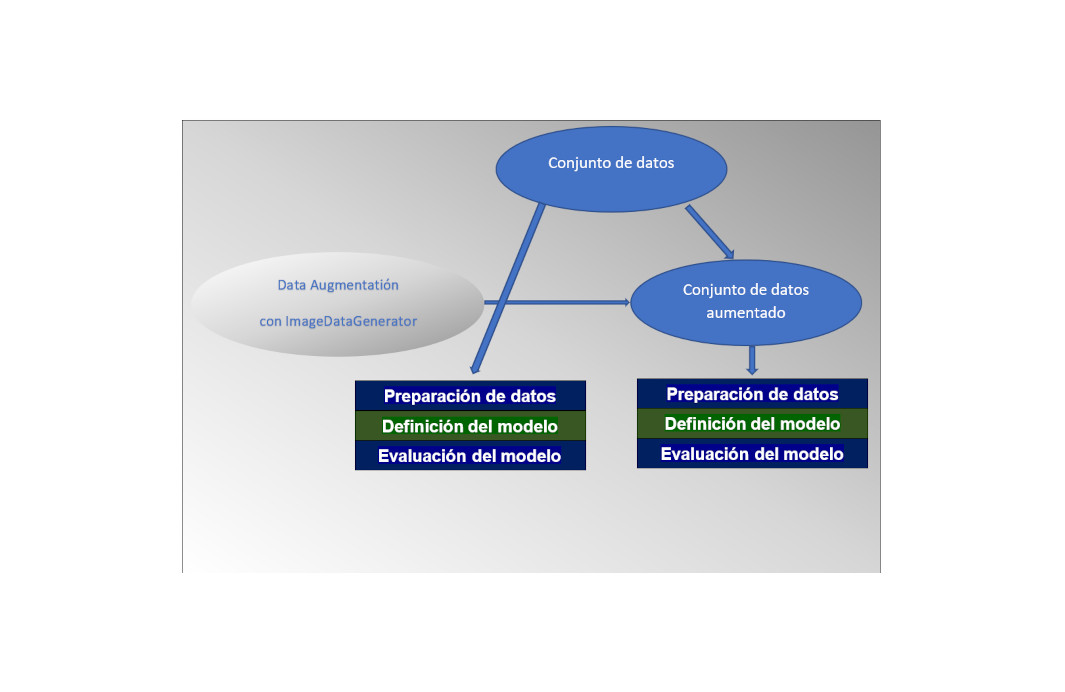
Data augmentation en redes neuronales es una técnica fundamental para evitar el sobreajuste de un modelo de aprendizaje automático. Consiste en generar nuevas muestras de datos a partir del conjunto de entrenamiento original mediante diversas transformaciones, lo que incrementa la diversidad de los datos y mejora la capacidad de generalización del modelo.
Estas transformaciones se aplican principalmente a imágenes y pueden incluir:
-
Rotación: Girar imágenes en diferentes ángulos para simular nuevas perspectivas.
-
Desplazamiento: Mover imágenes horizontal o verticalmente.
-
Escalado: Cambiar el tamaño de las imágenes, ampliándolas o reduciéndolas.
-
Reflejo: Invertir imágenes de forma horizontal o vertical.
-
Corte (cropping): Eliminar partes de la imagen para centrarse en diferentes regiones.
-
Ajuste de brillo y contraste: Modificar la luminosidad para crear variaciones en las condiciones de iluminación.
-
Adición de ruido: Introducir ruido aleatorio para hacer el modelo más robusto a imperfecciones.
Gracias al data augmentation, los modelos de deep learning pueden entrenarse con mayor eficacia y evitar errores comunes de sobreajuste, mejorando así su precisión en datos no vistos.
Ejemplo de transformación con ImageDataGenerator
Si tenemos la siguiente imagen:

Hacemos transformaciones de la imagen con el siguiente código usando ImageDataGenerator:
import matplotlib.pyplot as plt
from keras.preprocessing.image import ImageDataGenerator
import numpy as np
from matplotlib import pyplot
def getImagen(ruta):
    imagen = plt.imread(ruta)
    return imagen
def mostrarImagen(imagen):
    plt.imshow(imagen)
    plt.axis('off')
    plt.show()

def mostrar_imagenes(imagen,generador):
    # Añade una nueva dimension en el la posicion indicada por axis (458,458,3) a (1,458,458,3)
    img_array = np.expand_dims(imagen, axis=0)
    it=generador.flow(img_array, batch_size=1)
    for i in range(6):
        pyplot.subplot(230+1+i)
        batch = it.next()
        image = batch[0].astype('uint8')
        pyplot.imshow(image)
        pyplot.axis('on')
    plt.show()
ruta = 'Imagenes/Gatos/cat.1513.jpg'
imagen = getImagen(ruta)
generador = ImageDataGenerator(
        rotation_range=40,
        width_shift_range=0.2,
        height_shift_range=0.2,
        shear_range=0.2,
        zoom_range=0.2,
        horizontal_flip=True,
        fill_mode='nearest'
    )
generador = generador
mostrarImagen(imagen)
mostrar_imagenes(imagen,generador)

Donde se aplica una:
- rotation_range=40: Rotación de las imágenes dentro de un rango de 0 a 40 grados
- width_shift_range=0.2: Desplazamiento aleatorio de las imágenes horizontalmente en un 20% del ancho.
- height_shift_range=0.2: Desplazamiento aleatorio de las imágenes verticalmente en un 20% del ancho de altura.
- shear_range=0.2: Una transformación de cizalladura con una intensidad de 0.2.
- zoom_range=0.2: Un zoom aleatorio en las imágenes hasta un 20%.
- horizontal_flip=True: Inversión horizontalmente de las imágenes aleatoriamente.
- fill_mode=’nearest: Los valores de píxeles más cercanos se llenan con los nuevos píxeles creados por las transformaciones.
Aplicado a un conjunto de datos para aplicar Data augmentation
Si creamos los generadores para los datos de test, entrenamiento y validación:
train_datagen = ImageDataGenerator(
      rescale=1./255,
      rotation_range=40,
      width_shift_range=0.2,
      height_shift_range=0.2,
      shear_range=0.2,
      zoom_range=0.2,
      horizontal_flip=True,
      fill_mode='nearest')

validation_datagen  = ImageDataGenerator( rescale = 1.0/255. )
test_datagen  = ImageDataGenerator( rescale = 1.0/255. )
Lo aplicamos a la estructura de directorios del conjunto de datos donde están nuestras imágenes en las rutas train_dir, validation_dir, test_dir:
train_generator = train_datagen.flow_from_directory(train_dir,
                                                    batch_size=20,
                                                    class_mode='binary',
                                                    target_size=(150, 150))

validation_generator =  validation_datagen.flow_from_directory(validation_dir,
                                                         batch_size=20,
                                                         class_mode  = 'binary',
                                                         target_size = (150, 150))

test_generator =  test_datagen.flow_from_directory(test_dir,
                                                         batch_size=20,
                                                         class_mode  = 'binary',
                                                         target_size = (150, 150))
Después seguimos los pasos convencionales de preparación los de datos, definición, entrenamiento y evaluación del modelo.


