

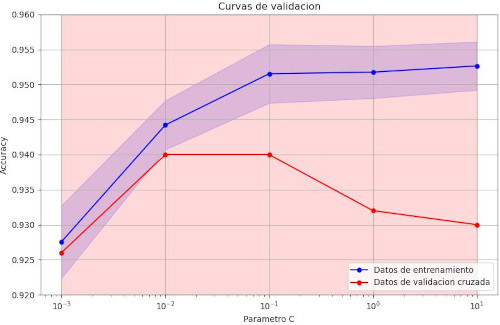
Curvas de validación en Machine Learning: diagnóstico y ajuste del hiperparámetro C
¿Qué son las curvas de validación en Machine Learning?
Las curvas de validacion en machine learning son una herramienta de diagnóstico fundamental que aprovecha la validación cruzada para evaluar el rendimiento de un modelo frente a distintos valores de un hiperparámetro específico, como por ejemplo el parámetro de regularización C. Estas curvas permiten visualizar de forma gráfica cómo cambia la precisión del modelo al ajustar los hiperparámetros, facilitando la identificación de posibles problemas de sobreajuste o subajuste.
¿Cómo generar curvas de validación con validation_curve()?
Para generar las curvas de validacion en machine learning, utilizamos la función validation_curve() de scikit-learn. Esta herramienta calcula automáticamente las puntuaciones de accuracy tanto en los datos de entrenamiento como en la validación cruzada, a medida que se modifican los valores del hiperparámetro seleccionado, como en este caso el valor de C.
Gracias a las curvas de validación, obtenemos una visión clara de cómo evoluciona el rendimiento del modelo conforme ajustamos el hiperparámetro. Esto resulta esencial para optimizar el comportamiento del modelo y seleccionar los valores más adecuados que equilibren el sesgo y la varianza, logrando así un rendimiento óptimo en predicciones futuras.
Parámetros clave de validation_curve():
Los parámetros de la función validation_curve() en machine learning son fundamentales para definir cómo se construyen las curvas de validación y obtener una evaluación precisa del modelo. A continuación, te explicamos cada uno de ellos:
-
estimator: Especifica el modelo que vamos a utilizar, por ejemplo, un pipeline que incluya pasos de preprocesamiento y el algoritmo de aprendizaje, como la regresión logística.
-
X e Y: Representan los datos de entrada, donde X contiene las características o variables independientes, e Y corresponde a las etiquetas o variable objetivo que queremos predecir.
-
param_name: Es el nombre del hiperparámetro que se desea ajustar. En este caso, usamos
"logisticregression__C", que hace referencia al parámetro C de la regresión logística, encargado de controlar la regularización del modelo. -
param_range: Define el rango de valores que se explorarán para el hiperparámetro. En este ejemplo, vamos a examinar valores de C comprendidos entre 0.001 y 10, lo que nos permitirá entender cómo estos afectan al rendimiento del modelo.
-
cv: Indica la cantidad de pliegues o particiones que se utilizarán en la validación cruzada. En este caso, se selecciona un valor de 10, garantizando así una evaluación más robusta y precisa del modelo a lo largo de diferentes divisiones de los datos.
Interpretación del gráfico: overfitting vs underfitting
Una curva de validación bien construida muestra:
- Aumento inicial del rendimiento con valores más altos de C.
- Estabilización o descenso en el rendimiento de validación al sobreajustar.
- Un punto óptimo de equilibrio entre entrenamiento y generalización.
Ejemplo en Python: regresión logística con validation_curve()
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.model_selection import validation_curve
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
def getDatos():
    X, Y = make_classification(n_samples=500, n_features=20, random_state=1)
    return X, Y

def divisionDatos(X, Y):
    X_train, X_test, y_train, y_test = train_test_split(
    X, Y, test_size=0.3, random_state=1, stratify=Y)
    return X_train, X_test, y_train, y_test
def curvasValidacion(X,Y,pipeline):
    rango_parametros = [0.001, 0.01, 0.1, 1, 10]
    train_scores, test_scores = validation_curve(
        estimator=pipeline,
        X=X,
        y=Y,
        param_name='logisticregression__C',
        param_range=rango_parametros,
        cv=10)
    train_mean = np.mean(train_scores, axis=1)
    train_std = np.std(train_scores, axis=1)
    test_mean = np.mean(test_scores, axis=1)
    test_std = np.std(test_scores, axis=1)
    plt.figure(figsize=(10, 6))
    plt.plot(rango_parametros, train_mean, color='blue', marker='o',
             markersize=5, label='Datos de entrenamiento')
    plt.fill_between(rango_parametros, train_mean + train_std,
                     train_mean - train_std, alpha=0.15, color='blue')
    plt.plot(rango_parametros, test_mean, color='red', marker='o',
             markersize=5, label='Datos de validacion')
    plt.fill_between(rango_parametros, test_mean + test_std,
                     test_mean - test_std, alpha=0.15, color='red')
    plt.title('Curvas de validacion')
    plt.xlabel('Parametro C')
    plt.ylabel('Accuracy')
    plt.legend(loc='lower right')
    plt.xscale('log')
    plt.ylim([0.92,0.96])
    plt.grid(True)
    plt.show()

X, y = getDatos()
X_train, X_test, y_train, y_test = divisionDatos(X,y)
pipeline = make_pipeline(StandardScaler(), LogisticRegression())
curvasValidacion(X,y,pipeline)
Resumen del código
Este código genera y visualiza una curva de validación para un modelo de regresión logística, utilizando un conjunto de datos sintético.
La idea es evaluar cómo afecta un hiperparámetro concreto (en este caso, el parámetro de regularización C) al rendimiento del modelo, tanto en los datos de entrenamiento como en la validación cruzada.
Paso a paso del código explicado:
-
Generación de datos sintéticos (
getDatos):-
Se crea un conjunto de datos ficticio con 500 muestras y 20 características, ideal para probar el modelo.
-
-
División de datos (
divisionDatos):-
Se separan los datos en conjunto de entrenamiento (70%) y de prueba (30%).
-
-
Creación del pipeline (
pipeline):-
Se construye un pipeline que incluye:
-
Estandarización de los datos (
StandardScaler). -
Modelo de regresión logística (
LogisticRegression).
-
-
-
Curva de validación (
curvasValidacion):-
Se define un rango de valores para el hiperparámetro C (
[0.001, 0.01, 0.1, 1, 10]). -
Se utiliza
validation_curve()para evaluar el rendimiento del modelo en cada valor de C, mediante validación cruzada de 10 particiones (cv=10). -
Se calcula la media y desviación estándar de las puntuaciones para los datos de entrenamiento y validación.
-
Finalmente, se genera un gráfico de curva de validación, que muestra cómo varía la precisión (accuracy) con diferentes valores de C.
-
¿Qué conceptos se aplican?
-
Curvas de validación:
Sirven para analizar cómo afecta un hiperparámetro al rendimiento del modelo. -
Regularización C en regresión logística:
C controla la penalización por complejidad del modelo; un valor bajo implica mayor regularización (modelo más simple), y un valor alto, menor regularización (modelo más complejo). -
Validación cruzada (cv=10):
Para evaluar de forma robusta cada valor de C. -
Visualización:
Se representa en un gráfico donde:-
La línea azul muestra la precisión del conjunto de entrenamiento.
-
La línea roja muestra la precisión del conjunto de validación.
-
El área sombreada representa la variabilidad de las puntuaciones.
-
Conclusión rápida:
Este código permite visualizar cómo cambia la precisión del modelo de regresión logística al ajustar el hiperparámetro C, ayudándote a encontrar el equilibrio entre subajuste y sobreajuste, y mejorar la generalización del modelo.
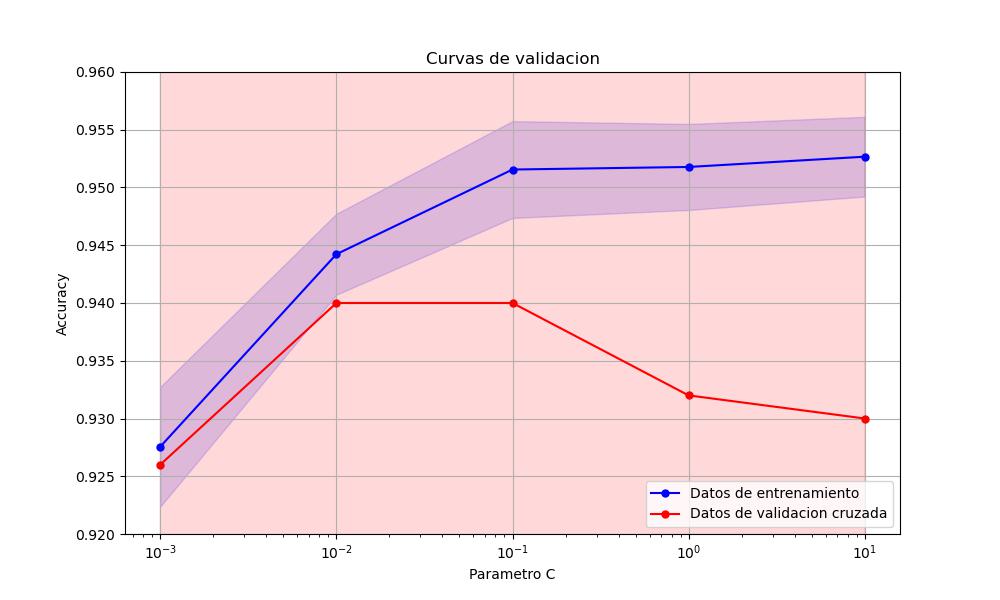
Interpretación de las curvas de validación en función del parámetro de regularización C
Los resultados obtenidos en las curvas de validación muestran claramente cómo varía el rendimiento del modelo de regresión logística al modificar el parámetro de regularización C.
Estas curvas de validación en machine learning representan gráficamente el comportamiento del modelo frente a distintos valores de C. Se observa que, a medida que aumenta el valor de este hiperparámetro, tanto las puntuaciones de entrenamiento como las de validación tienden a mejorar inicialmente. Sin embargo, a partir de C = 1, las puntuaciones de validación se estabilizan o incluso disminuyen ligeramente, lo que sugiere un posible sobreajuste del modelo. Por ello, un rango de C entre 0.1 y 1 parece ser una elección adecuada para mantener un buen equilibrio entre ajuste y generalización.
Cuando C es igual a 0.1, se aplica una regularización más fuerte en el modelo de regresión logística. Este valor bajo penaliza más intensamente los coeficientes del modelo, ayudando a evitar el sobreajuste al limitar su complejidad.
En cambio, con C = 1, observamos que las puntuaciones de entrenamiento y validación son elevadas, lo que indica un rendimiento óptimo del modelo en ambos conjuntos de datos. Este valor de C permite un equilibrio entre flexibilidad y capacidad de generalización.
Por otro lado, cuando C supera el valor de 1, las puntuaciones de validación dejan de mejorar e incluso pueden empezar a disminuir. Este comportamiento señala un aumento en la complejidad del modelo, favoreciendo el sobreajuste y disminuyendo la capacidad de generalizar a nuevos datos.
En conclusión, dentro de las curvas de validación, un valor de C = 1 ofrece un rendimiento general sólido, pero considerar un valor ligeramente inferior, como 0.1, podría proporcionar un mejor equilibrio entre precisión y generalización, dependiendo de la naturaleza específica del problema que se esté abordando.
Conclusión
Las curvas de validación en Machine Learning permiten entender cómo el ajuste de hiperparámetros afecta el rendimiento de un modelo. En particular, ajustar correctamente el valor de C en regresión logística mejora la generalización y reduce el riesgo de sobreajuste. Esta técnica es clave para la optimización de modelos supervisados.


