

Las curvas de aprendizaje
Las curvas de aprendizaje son una herramienta fundamental en machine learning para entender cómo se comporta un modelo a medida que recibe más datos de entrenamiento. Estas curvas permiten visualizar la relación entre el rendimiento del modelo y el tamaño del conjunto de datos, ayudando a identificar si el modelo está subajustado, sobreajustado o bien equilibrado.
¿Qué son las curvas de aprendizaje?
Las curvas de aprendizaje representan gráficamente cómo varía la precisión o el error del modelo en función de la cantidad de datos de entrenamiento utilizados. Normalmente, se trazan dos líneas:
- Curva de entrenamiento: muestra cómo de bien se desempeña el modelo en los datos con los que fue entrenado.
- Curva de validación: indica el rendimiento del modelo sobre un conjunto de datos que no ha visto durante el entrenamiento.
Analizando estas curvas juntas, es posible diagnosticar problemas de aprendizaje, como el sobreajuste o el subajuste.
¿Para qué sirven las curvas de aprendizaje?
Las curvas de aprendizaje son muy útiles para:
- Diagnosticar el comportamiento del modelo: si el modelo está aprendiendo correctamente o necesita ajustes.
- Detectar sobreajuste (overfitting): cuando la curva de entrenamiento está muy por encima de la curva de validación.
- Identificar subajuste (underfitting): cuando ambas curvas muestran un rendimiento bajo.
- Decidir si merece la pena añadir más datos de entrenamiento.
- Optimizar el modelo: ayudan a entender si es mejor ajustar hiperparámetros o probar algoritmos más complejos.
En resumen, estas curvas te permiten tomar decisiones informadas para mejorar tus modelos predictivos.
¿Cómo hacer una curva de aprendizaje?
Crear una curva de aprendizaje es sencillo utilizando herramientas como scikit-learn en Python. Estos son los pasos generales:
- Selecciona un modelo: por ejemplo, un árbol de decisión o una regresión logística.
- Prepara los datos: asegúrate de tener un conjunto de datos bien estructurado.
- Usa la función learning_curve() de scikit-learn para calcular el rendimiento del modelo en función de diferentes tamaños de entrenamiento.
- Visualiza la curva utilizando bibliotecas como matplotlib.
Ejemplo básico en Python:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.model_selection import learning_curve
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
def getDatos():
    X, Y = make_classification(n_samples=1000, n_features=20, random_state=1)
    return X, Y

def divisionDatos(X, Y):
    X_train, X_test, y_train, y_test = train_test_split(
    X, Y, test_size=0.3, random_state=1, stratify=Y)
    return X_train, X_test, y_train, y_test
def curvasAprendizaje(X_train,y_train,pipeline):
    train_sizes, train_scores, test_scores =\
                                learning_curve(estimator=pipeline,
                                X=X_train,
                                y=y_train,
                                train_sizes=np.linspace(0.1, 1.0, 10),
                                cv=10,
                                n_jobs=1)
    train_mean = np.mean(train_scores, axis=1)
    train_std = np.std(train_scores, axis=1)
    test_mean = np.mean(test_scores, axis=1)
    test_std = np.std(test_scores, axis=1)
    plt.figure(figsize=(10, 6))
    plt.plot(train_sizes, train_mean, color='blue', marker='o',
             markersize=5, label='Datos de entrenamiento')
    plt.fill_between(train_sizes, train_mean + train_std,
                     train_mean - train_std, alpha=0.15, color='blue')
    plt.plot(train_sizes, test_mean, color='red', marker='o',
             markersize=5, label='Datos de prueba')
    plt.fill_between(train_sizes, test_mean + test_std,
                     test_mean - test_std, alpha=0.15, color='red')
    plt.title('Curvas de Aprendizaje')
    plt.xlabel('Tamaño del conjunto de entrenamiento')
    plt.ylabel('Accuracy')
    plt.legend(loc='lower right')
    plt.grid(True)
    plt.show()

X, y = getDatos()
X_train, X_test, y_train, y_test = divisionDatos(X,y)
pipeline = make_pipeline(StandardScaler(), LogisticRegression())
curvasAprendizaje(X_train,y_train,pipeline)
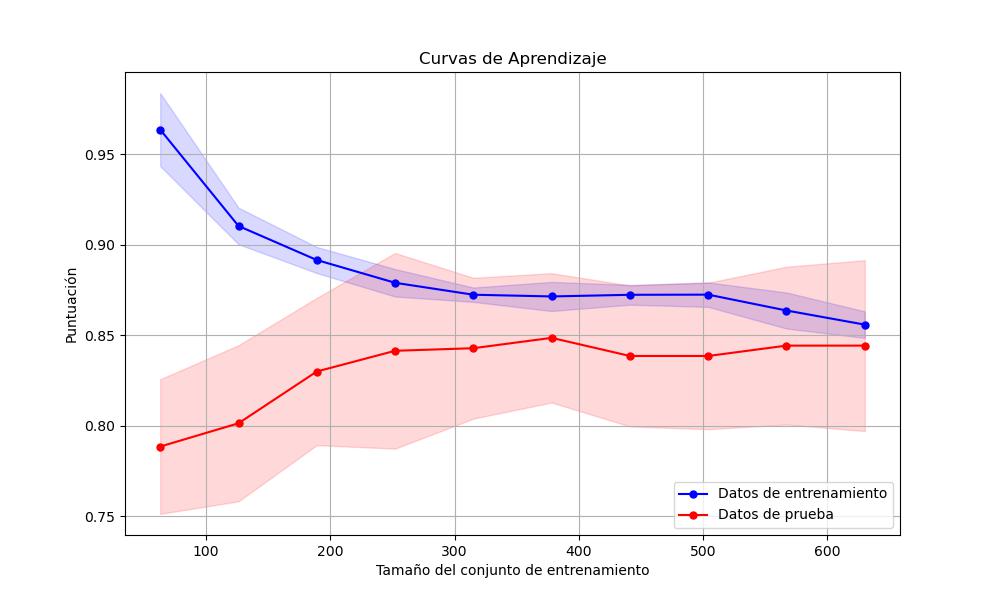
Descripción de la imagen
La imagen muestra una curva de aprendizaje generada a partir del código que analizamos antes. El gráfico ilustra cómo varía la precisión del modelo dependiendo del tamaño del conjunto de entrenamiento.
Ejes del gráfico:
- Eje X (horizontal):
Representa el tamaño del conjunto de entrenamiento, es decir, cuántos datos se han usado para entrenar el modelo. - Eje Y (vertical):
Muestra la puntuación de precisión del modelo (accuracy), tanto en entrenamiento como en prueba.
Curvas que aparecen:
- Línea azul:
Precisión sobre el conjunto de entrenamiento.- Al principio, con pocos datos, la precisión es muy alta (casi perfecta). Esto es típico, porque el modelo memoriza fácilmente un conjunto de datos pequeño.
- A medida que aumentamos la cantidad de datos, la precisión de entrenamiento baja ligeramente y se estabiliza, lo cual es normal: el modelo necesita generalizar, no memorizar.
- Línea roja:
Precisión sobre el conjunto de prueba.- Comienza más baja que la línea azul, pero va aumentando a medida que agregamos más datos al entrenamiento.
- Se estabiliza, aunque no llega a la misma altura que la curva de entrenamiento, pero la distancia entre ambas se reduce.
- Sombras alrededor de las líneas (bandas de color):
Representan la variabilidad (desviación estándar) de las puntuaciones en cada punto, indicando qué tan consistente es la precisión.
Interpretación del comportamiento del modelo:
- Inicialmente hay alta varianza: la curva de entrenamiento está mucho más alta que la de prueba.
- Con más datos, la precisión de prueba mejora y la diferencia entre ambas curvas disminuye.
- Finalmente, ambas curvas se acercan, lo que indica que el modelo está empezando a generalizar mejor.
Conclusión de la imagen:
El modelo empieza con signos de sobreajuste (overfitting), pero conforme aumentamos el tamaño del conjunto de entrenamiento, mejora la capacidad de generalización, reduciendo la diferencia entre el rendimiento en entrenamiento y prueba.
Resumen simple:
| Observación | Significado |
| Alta precisión inicial en entrenamiento | Memorización de pocos datos (sobreajuste). |
| Mejora progresiva en prueba | Más datos ayudan al modelo a generalizar. |
| Reducción de la diferencia entre curvas | El modelo se estabiliza y aprende patrones generales. |
Recomendación práctica:
Si seguimos aumentando los datos de entrenamiento, probablemente la curva de prueba seguirá subiendo ligeramente o estabilizándose, y el modelo se volverá aún más robusto.
Resumen del código
Este código genera y visualiza curvas de aprendizaje para un modelo de regresión logística utilizando un conjunto de datos sintético de clasificación.
Desglose rápido de lo que hace:
- Generación de datos sintéticos (getDatos):
- Crea un conjunto de datos de clasificación ficticio con 1000 muestras y 20 características usando make_classification.
- División de datos (divisionDatos):
- Separa los datos en un conjunto de entrenamiento (70%) y otro de prueba (30%).
- Definición del pipeline:
- Se construye un pipeline que incluye:
- Estandarización de características (StandardScaler).
- Modelo de regresión logística (LogisticRegression).
- Se construye un pipeline que incluye:
- Curvas de aprendizaje (curvasAprendizaje):
- Calcula cómo varía la precisión del modelo al entrenar con diferentes cantidades de datos.
- Usa validación cruzada de 10 particiones (cv=10) para estimar el rendimiento.
- Calcula la media y desviación estándar de las puntuaciones de entrenamiento y prueba.
- Dibuja las curvas de aprendizaje mostrando cómo cambia la precisión a medida que aumentan los datos de entrenamiento.
- Visualización final:
- Muestra en un gráfico las curvas de rendimiento para entrenamiento y prueba, facilitando la interpretación de si el modelo está bien ajustado, subajustado o sobreajustado.
Conclusión sencilla:
Este código genera un conjunto de datos ficticio, entrena un modelo de regresión logística y visualiza sus curvas de aprendizaje para analizar cómo evoluciona la precisión cuando aumentamos el tamaño del conjunto de entrenamiento.
Conclusión
Las curvas de aprendizaje son una herramienta esencial para cualquier proyecto de machine learning. Nos ayundan a comprender cómo evoluciona el rendimiento de un modelo, a detectar problemas de sobreajuste o subajuste, y a decidir si necesitamos más datos o una estrategia de modelado diferente.
Incorporar estas curvas en tu flujo de trabajo nos permitirá construir modelos más robustos y eficientes, mejorando así nuestras predicciones y resultados finales.


