

Como entrenar una red neuronal
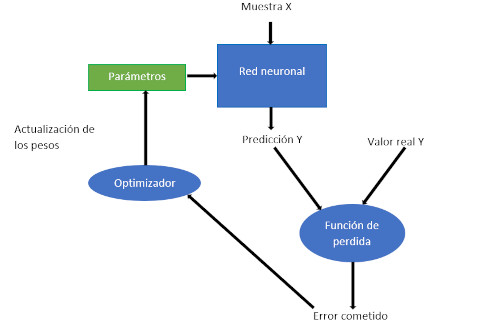
Para entrenar una red neuronal, primero se preparan los datos de entrenamiento y prueba, asegurándose de que estén limpios (sin valores ausentes) y correctamente formateados, incluyendo el tratamiento de datos categóricos. Luego, se define la arquitectura de la red neuronal, especificando el número de capas ocultas, el tipo de capas y las funciones de activación.
Una vez definida la arquitectura, se compila el modelo indicando la función de pérdida, que evalúa el rendimiento del modelo, y el optimizador, que ajusta los pesos durante el entrenamiento para minimizar dicha pérdida.
Con el modelo compilado, se procede al entrenamiento de la red neuronal utilizando los datos preparados. Durante este proceso, el modelo ajusta sus pesos en función del optimizador seleccionado, dependiendo del tipo de problema: clasificación binaria, multiclase o regresión. Este ciclo de entrenamiento se repite durante varias épocas, cada una de las cuales representa una pasada completa por los datos de entrenamiento.
Finalmente, tras completar el entrenamiento, se evalúa el rendimiento del modelo con los datos de prueba.
Conceptos a tener en cuenta para entrenar una red neuronal
Función de pérdida en redes neuronales
Durante el entrenamiento de una red neuronal, se ajustan los pesos de la red para minimizar la función de pérdida. Este proceso comienza al pasar los datos de entrenamiento a través de la red, que realiza predicciones. Luego se calcula la discrepancia entre las predicciones y las etiquetas verdaderas mediante una función de pérdida, la cual cuantifica el error del modelo.
Optimizador en el entrenamiento de modelos
Una vez obtenida la pérdida, se emplea un optimizador, como el gradiente descendente, para ajustar los pesos de la red. El objetivo es encontrar los valores óptimos que minimicen la función de pérdida. Este ajuste se realiza iterativamente durante todo el proceso de entrenamiento.
Algoritmo de retropropagación
El ajuste de los pesos se lleva a cabo mediante el algoritmo de retropropagación. Este algoritmo calcula los gradientes de la función de pérdida respecto a los pesos de cada capa, y utiliza esos valores para actualizar los pesos en función del error cometido.
Iteraciones y épocas en el entrenamiento
El ciclo de entrenamiento incluye la propagación hacia adelante, el cálculo de la pérdida, la retropropagación y la actualización de pesos. Este proceso se repite durante múltiples épocas, donde cada época representa una pasada completa del conjunto de entrenamiento por la red neuronal.
Evaluación del modelo entrenado
Después del entrenamiento, el modelo se evalúa con datos de prueba para medir su precisión y otras métricas de rendimiento. Esta evaluación es crucial para determinar la capacidad del modelo para generalizar sobre datos no vistos.


