
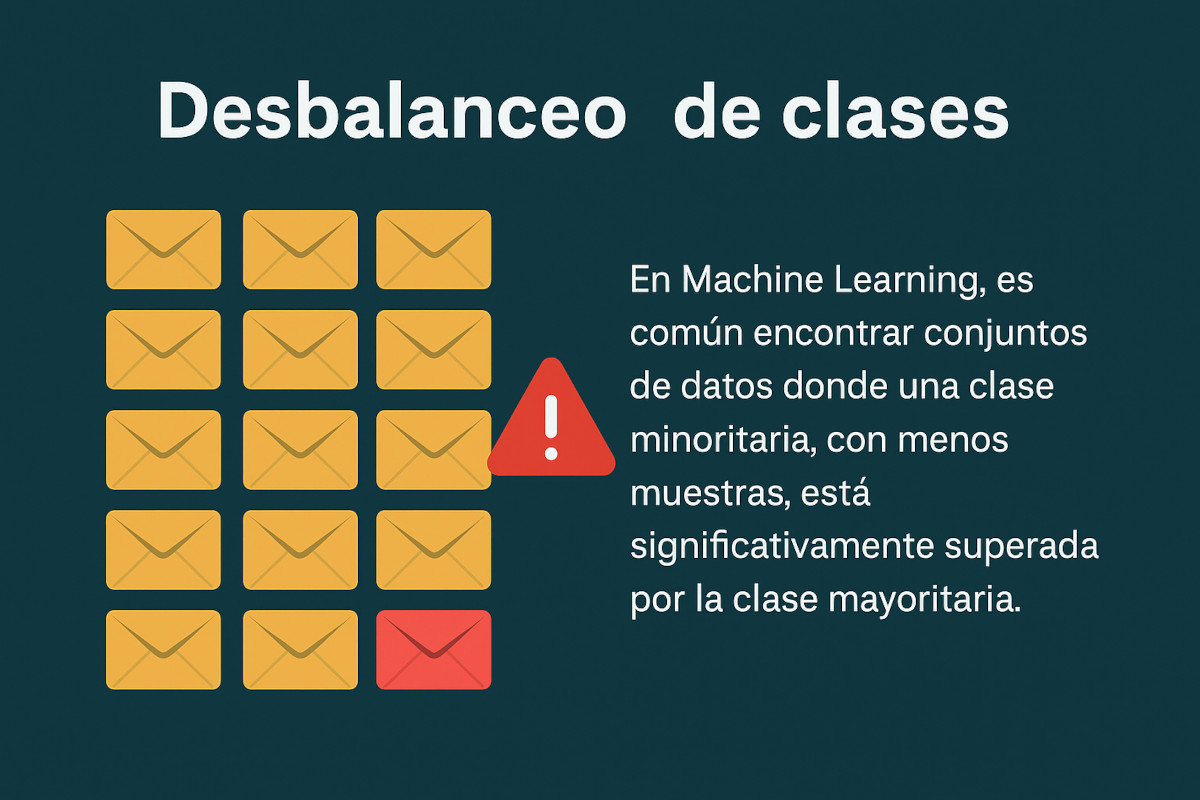
Imagen sobre el desbalanceo de clases en machine learning, que muestra visualmente la diferencia entre clases mayoritarias y minoritarias en un conjunto de datos.

En Machine Learning, uno de los retos más comunes en problemas de clasificación es el desbalanceo de clases. Este ocurre cuando una de las clases del conjunto de datos tiene muchas más muestras que la otra, lo que puede afectar negativamente al rendimiento del modelo.

Por ejemplo, al entrenar un algoritmo para detectar si un correo es spam o no, es habitual encontrar un conjunto de datos muy desequilibrado: imagina un dataset con 9900 correos legítimos y solo 100 correos spam. Esta distribución desigual hace que el modelo aprenda a predecir siempre la clase mayoritaria (correos legítimos), ignorando la minoritaria (spam), generando falsas predicciones.

Esto puede llevar a un modelo con una alta precisión aparente (99%), pero que falla en detectar los pocos casos importantes, como los correos no deseados. En consecuencia, la clase minoritaria queda subrepresentada, perjudicando su correcta clasificación y afectando la capacidad de generalización del modelo.

¿Cuándo un dataset está desbalanceado?
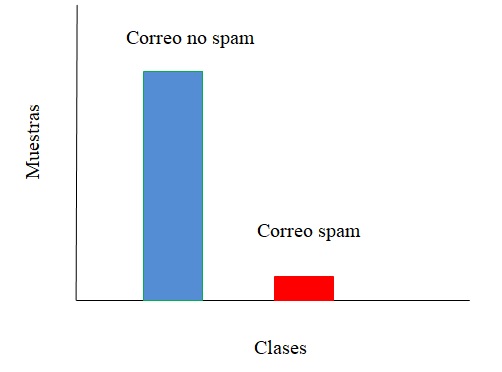
Desbalanceo de datos

Desbalanceo de datos

Desbalanceo de datos

Si tenemos un modelo de 10000 muestras:

En la exactitud: ¿Cuál es la proporción de instancias que ha clasificado correctamente el algoritmo?

exactitud = (verdaderos positivos + verdaderos negativos) / (total de instancias)

exactitud = (9900 + 0) / (10000)= 0.99

En este caso la exactitud del modelo nos da el 99% cuando no hemos logrado identificar ningún correo de spam.

En la precisión: ¿Qué porcentaje de correos legítimos ha clasificado correctamente el algoritmo?

precisión = verdaderos positivos / (verdaderos positivos + falsos positivos)

precisión = 9900 / (9900+ 100)

La precisión del modelo nos da el 99%

En el Recall: ¿Qué porcentaje de correo legitimo el modelo ha clasificado correctamente como positivos?

Recall = verdaderos positivos / (verdaderos positivos + falsos negativos)

Recall = 9900 / (9900+ 100)=100

Para correo legitimo es capaz de identificar el 100%

El desbalanceo de datos es un problema común en machine learning que ocurre cuando las clases dentro de un conjunto de datos están desigualmente representadas. Esto puede llevar a resultados engañosos en las métricas de evaluación del modelo. Por ejemplo, consideremos un modelo entrenado con 10.000 muestras, de las cuales 9.900 pertenecen a la clase “no spam” y solo 100 a la clase “spam”. En este escenario, la exactitud (accuracy) del modelo se calcula como el número de predicciones correctas dividido por el total de instancias:
(9900 verdaderos positivos + 0 verdaderos negativos) / 10000 = 0.99, lo que da una exactitud del 99%. Sin embargo, este valor es engañoso, ya que el modelo no ha identificado correctamente ningún correo spam.

Al analizar la precisión (precision), que mide el porcentaje de instancias clasificadas como positivas que realmente lo son, obtenemos:
9900 / (9900 + 100) = 0.99, es decir, 99% de precisión para los correos legítimos. Nuevamente, el modelo parece funcionar bien, pero sigue ignorando por completo la clase minoritaria.

Por último, el recall (sensibilidad), que indica el porcentaje de verdaderos positivos correctamente identificados, también resulta ser:
9900 / (9900 + 100) = 0.99, lo que representa una tasa de recuperación del 99% para la clase mayoritaria. Sin embargo, el modelo falla completamente al detectar la clase de interés (spam).

Este ejemplo demuestra cómo el desbalanceo de clases puede falsear las métricas de evaluación, creando una falsa sensación de rendimiento. En estos casos, se recomienda utilizar métricas más robustas como F1-score, matriz de confusión o curvas ROC-AUC, además de aplicar técnicas de resampling o algoritmos diseñados específicamente para datos desbalanceados.

¿Cómo sacar el desbalance de las clases desbalanceadas?

Para sacar el desbalance de clases tenemos varias opciones:

  • Ponderando las clases: Asignando pesos diferentes a las clases en función de su frecuencia relativa en el conjunto de datos. Los pesos más altos se asignan a las clases minoritarias para aumentar su influencia durante el entrenamiento del modelo.
  • Oversampling: Aumentado el número de muestras de las clases minoritarias duplicando, nuevas muestras sintéticas.
  • Undersampling: Reduciendo el número de muestras de las clases mayoritarias para equilibrar las clases con menos representación.
  • Enfoques de ensamble: Entrenando varios modelos y después combinando sus predicciones.

Preguntas frecuentes sobre las clases desbalanceadas

Penalización mayor a las predicciones erróneas en las clases minoritarias mediante ponderaciones

from sklearn.datasets import make_classification
from collections import Counter
from sklearn.utils import compute_class_weight
import numpy as np
X, Y = make_classification(n_samples=10000, n_features=2, n_redundant=0,n_clusters_per_class=1, weights=[0.99], flip_y=0, random_state=2)
counter = Counter(Y)
cw=compute_class_weight(class_weight='balanced',classes=[0,1], y=Y) 
print("La relación entre clases es:", counter)
print("La ponderación es:", cw)
print("class_weight es de: " )
La relación entre clases es: Counter()
La ponderación es: [ 0.50505051 50. ]
class_weight es de: 

Por lo que si la ponderación es 0.50:50 entonces implica que la ponderación es 1:100

Descripción del código:

  • make_classification sirve para generar un conjunto de datos de clasificación.
  • Counter nos dice los elementos de cada clase en el conjunto de etiquetas, es decir 9900 de la clase 0 y 100 de la clase 1.
  • compute_class_weight nos dice la ponderación de clases.

A continuación, se generamos un conjunto de datos de clasificación utilizando la función make_classification especificando el número de muestras, características, redundancias, clusters por clase, peso de la clase y una semilla aleatoria.

Luego, utilizamos Counter pasa saber los elementos de cada clase en el conjunto de etiquetas y almacenarlo en la variable counter.

Después,  utilizamos la función compute_class_weight para saber la ponderación de clases utilizando la opción class_weight='balanced' y almacenarlos en la variable cw.

Finalmente, imprimimos en pantalla la relación entre clases, la ponderación de clases, por lo que si la ponderación es 0.50:50 entonces implica que la ponderación es 1:100

Resample para el desbalanceo de clases

Mediante la duplicación o eliminación de muestras en las clases minoritarias vamos a modificar el conjunto de datos para igualar la cantidad de muestras en las clases minoritarias a la cantidad de muestras en la clase mayoritaria.

Para ello vamos a crear un conjunto de datos equilibrado para que el modelo de aprendizaje automático pueda aprender de manera más equitativa las características de todas las clases y evitar el sesgo hacia la clase mayoritaria.

Se puede realizar de dos maneras:

  1. Oversampling: Consiste en duplicar aleatoriamente muestras de las clases minoritarias hasta que la cantidad de muestras en las clases minoritarias sea igual a la cantidad de muestras en la clase mayoritaria.
  2. Undersampling: Consiste en eliminar aleatoriamente muestras de la clase mayoritaria hasta que la cantidad de muestras en las clases minoritarias sea igual a la cantidad de muestras en la clase mayoritaria.
#Ponderación de clases en la regresión logística
from unicodedata import decimal
from sklearn.datasets import make_classification
from sklearn.preprocessing import LabelEncoder
from sklearn.model_selection import train_test_split
from sklearn.metrics import precision_score
from sklearn.metrics import accuracy_score
from sklearn.metrics import recall_score
from sklearn.metrics import confusion_matrix
from sklearn.metrics import f1_score
from sklearn.utils.class_weight import compute_class_weight
from sklearn.model_selection import RepeatedStratifiedKFold
from collections import Counter
from sklearn.model_selection import cross_val_score
import numpy as np
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import GridSearchCV
import matplotlib.pyplot as plt
from sympy import div
from sklearn.utils import resample
def getDatos():   
    #Creamos un dataset desbalanceado  
    X, Y = make_classification(n_samples=10000, n_features=2, n_redundant=0,
    n_clusters_per_class=1, weights=[0.99], flip_y=0, random_state=2)       
    return X,Y 

def divisionDatos(X,Y):
    X_train, X_test, y_train, y_test = train_test_split(X, Y, 
                     test_size=0.7,
                     stratify=Y,
                     random_state=1)
    return X_train, X_test, y_train, y_test 

def getModelo(ponderacion):
    lg = LogisticRegression(solver='lbfgs',class_weight=ponderacion)
    return lg
def metricas(modelo,y_test,y_predic):
    print('La matriz de confusion es: ')
    matriz = confusion_matrix(y_test,y_predic)
    print(matriz)   
    print('La exactitud es: %.3f' % accuracy_score(y_test,y_predic))   
    print('La precision de la clase 0 es:', matriz[0,0] / (matriz[0,0] + matriz[1,0]))
    print('La precision de la clase 1 es:', matriz[1,1] / (matriz[1,1] + matriz[0,1]))
    print('La exahustividad de la clase 0 es:', matriz[0,0] / (matriz[0,0] + matriz[0,1]))
    print('La exahustividad de la clase 1 es:', matriz[1,1] / (matriz[1,0] + matriz[1,1]))
    cvc = cross_val_score(modelo, X, Y, scoring='roc_auc', cv=10, n_jobs=-1)
    print('Mean ROC AUC modelo: %.3f' % np.mean(cvc))
    print()

def resampled(X,Y):
    c=X[Y == 0].shape[0] #Numero de filas con valor 0
    #Crea muestras repetidas en la clase 1 hasta igualar el tamaño a la clase 0
    X_upsampled, y_upsampled = resample(X[Y == 1],
                                        Y[Y == 1],
                                        replace=True,
                                        n_samples=c,
                                        random_state=123)
    X_val = np.vstack((X[Y==0],X_upsampled))
    Y_val = np.hstack((Y[Y==0],y_upsampled))
    print(np.bincount(Y_val))
    modelo1=getModelo(ponderacion='None')
    modelo1.fit(X_train,y_train)
    y_predic = modelo1.predict(X_test)
    metricas(modelo1,y_test,y_predic)
X,Y= getDatos()
X_train, X_test, y_train, y_test = divisionDatos(X,Y)
resampled(X,Y)
[9900 9900]
La matriz de confusion es: 
[[6929 1]
[ 27 43]]
La exactitud es: 0.996
La precision de la clase 0 es: 0.9961184588844163
La precision de la clase 1 es: 0.9772727272727273
La exahustividad de la clase 0 es: 0.9998556998556999
La exahustividad de la clase 1 es: 0.6142857142857143
Mean ROC AUC modelo: 0.986

Si tenemos los siguientes tipos de ponderación:

  • Ponderación a none
  • Ponderación a 1:100
  • Ponderación a 1:10
  • Ponderación balanceada
  • Búsqueda del mejor modelo para tres tipos de ponderación mediante cuadriculas

Ponderación a none

from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import confusion_matrix
from sklearn.model_selection import cross_val_score
import numpy as np
from sklearn.linear_model import LogisticRegression
def getDatos():   
    #Creamos un dataset desbalanceado  
    X, Y = make_classification(n_samples=10000, n_features=2, n_redundant=0,
        n_clusters_per_class=1, weights=[0.99], flip_y=0, random_state=2)
    return X,Y
def metricas(y_test,y_predic):
    print('La matriz de confusion es: ')
    matriz = confusion_matrix(y_test,y_predic)
    print(matriz)   
    print('La exactitud es: %.3f' % accuracy_score(y_test,y_predic))   
    print('La precision de la clase 0 es:', matriz[0,0] / (matriz[0,0] + matriz[1,0]))
    print('La precision de la clase 1 es:', matriz[1,1] / (matriz[1,1] + matriz[0,1]))
    print('La exahustividad de la clase 0 es:', matriz[0,0] / (matriz[0,0] + matriz[0,1]))
    print('La exahustividad de la clase 1 es:', matriz[1,1] / (matriz[1,0] + matriz[1,1]))
    cvc = cross_val_score(lg, X, Y, scoring='roc_auc', cv=10, n_jobs=-1)
    print('Mean ROC AUC modelo: %.3f' % np.mean(cvc)) 
    print()
def divisionDatos(X,Y):
    X_train, X_test, y_train, y_test = train_test_split(X, Y, 
                     test_size=0.7,
                     stratify=Y,
                     random_state=1)
    return X_train, X_test, y_train, y_test 
X,Y= getDatos()
X_train, X_test, y_train, y_test = divisionDatos(X,Y)
lg = LogisticRegression(solver='lbfgs',class_weight='None')
lg.fit(X_train,y_train)
y_predic = lg.predict(X_test)
metricas(y_test,y_predic)

La matriz de confusion es: 
[[6929 1]
[ 27 43]]
La exactitud es: 0.996
La precision de la clase 0 es: 0.9961184588844163
La precision de la clase 1 es: 0.9772727272727273
La exahustividad de la clase 0 es: 0.9998556998556999
La exahustividad de la clase 1 es: 0.6142857142857143
Mean ROC AUC modelo: 0.986


Ponderacion de 1 a 100

from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import confusion_matrix
from sklearn.model_selection import cross_val_score
import numpy as np
from sklearn.linear_model import LogisticRegression
def getDatos():   
    #Creamos un dataset desbalanceado  
    X, Y = make_classification(n_samples=10000, n_features=2, n_redundant=0,
        n_clusters_per_class=1, weights=[0.99], flip_y=0, random_state=2)
    return X,Y
def metricas(y_test,y_predic):
    print('La matriz de confusion es: ')
    matriz = confusion_matrix(y_test,y_predic)
    print(matriz)   
    print('La exactitud es: %.3f' % accuracy_score(y_test,y_predic))   
    print('La precision de la clase 0 es:', matriz[0,0] / (matriz[0,0] + matriz[1,0]))
    print('La precision de la clase 1 es:', matriz[1,1] / (matriz[1,1] + matriz[0,1]))
    print('La exahustividad de la clase 0 es:', matriz[0,0] / (matriz[0,0] + matriz[0,1]))
    print('La exahustividad de la clase 1 es:', matriz[1,1] / (matriz[1,0] + matriz[1,1]))
    cvc = cross_val_score(lg, X, Y, scoring='roc_auc', cv=10, n_jobs=-1)
    print('Mean ROC AUC modelo: %.3f' % np.mean(cvc)) 
    print()
def divisionDatos(X,Y):
    X_train, X_test, y_train, y_test = train_test_split(X, Y, 
                     test_size=0.7,
                     stratify=Y,
                     random_state=1)
    return X_train, X_test, y_train, y_test 
X,Y= getDatos()
X_train, X_test, y_train, y_test = divisionDatos(X,Y)
lg = LogisticRegression(solver='lbfgs',class_weight=)
lg.fit(X_train,y_train)
y_predic = lg.predict(X_test)
metricas(y_test,y_predic)
La matriz de confusion es: 
[[6444 486]
[ 3 67]]
La exactitud es: 0.930
La precision de la clase 0 es: 0.9995346672871103
La precision de la clase 1 es: 0.12115732368896925
La exahustividad de la clase 0 es: 0.9298701298701298
La exahustividad de la clase 1 es: 0.9571428571428572
Mean ROC AUC modelo: 0.990

Ponderación de 1 a 10

from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import confusion_matrix
from sklearn.model_selection import cross_val_score
import numpy as np
from sklearn.linear_model import LogisticRegression
def getDatos():   
    #Creamos un dataset desbalanceado  
    X, Y = make_classification(n_samples=10000, n_features=2, n_redundant=0,
        n_clusters_per_class=1, weights=[0.99], flip_y=0, random_state=2)
    return X,Y
def metricas(y_test,y_predic):
    print('La matriz de confusion es: ')
    matriz = confusion_matrix(y_test,y_predic)
    print(matriz)   
    print('La exactitud es: %.3f' % accuracy_score(y_test,y_predic))   
    print('La precision de la clase 0 es:', matriz[0,0] / (matriz[0,0] + matriz[1,0]))
    print('La precision de la clase 1 es:', matriz[1,1] / (matriz[1,1] + matriz[0,1]))
    print('La exahustividad de la clase 0 es:', matriz[0,0] / (matriz[0,0] + matriz[0,1]))
    print('La exahustividad de la clase 1 es:', matriz[1,1] / (matriz[1,0] + matriz[1,1]))
    cvc = cross_val_score(lg, X, Y, scoring='roc_auc', cv=10, n_jobs=-1)
    print('Mean ROC AUC modelo: %.3f' % np.mean(cvc)) 
    print()
def divisionDatos(X,Y):
    X_train, X_test, y_train, y_test = train_test_split(X, Y, 
                     test_size=0.7,
                     stratify=Y,
                     random_state=1)
    return X_train, X_test, y_train, y_test 
X,Y= getDatos()
X_train, X_test, y_train, y_test = divisionDatos(X,Y)
lg = LogisticRegression(solver='lbfgs',class_weight=)
lg.fit(X_train,y_train)
y_predic = lg.predict(X_test)
metricas(y_test,y_predic)

La matriz de confusion es:[[6855 75] [ 12 58]] La exactitud es: 0.988
La precision de la clase 0 es: 0.9982525120139799
La precision de la clase 1 es: 0.43609022556390975
La exahustividad de la clase 0 es: 0.9891774891774892
La exahustividad de la clase 1 es: 0.8285714285714286
Mean ROC AUC modelo: 0.989

Ponderación balanceada

from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import confusion_matrix
from sklearn.model_selection import cross_val_score
import numpy as np
from sklearn.linear_model import LogisticRegression
def getDatos():   
    #Creamos un dataset desbalanceado  
    X, Y = make_classification(n_samples=10000, n_features=2, n_redundant=0,
        n_clusters_per_class=1, weights=[0.99], flip_y=0, random_state=2)
    return X,Y
def metricas(y_test,y_predic):
    print('La matriz de confusion es: ')
    matriz = confusion_matrix(y_test,y_predic)
    print(matriz)   
    print('La exactitud es: %.3f' % accuracy_score(y_test,y_predic))   
    print('La precision de la clase 0 es:', matriz[0,0] / (matriz[0,0] + matriz[1,0]))
    print('La precision de la clase 1 es:', matriz[1,1] / (matriz[1,1] + matriz[0,1]))
    print('La exahustividad de la clase 0 es:', matriz[0,0] / (matriz[0,0] + matriz[0,1]))
    print('La exahustividad de la clase 1 es:', matriz[1,1] / (matriz[1,0] + matriz[1,1]))
    cvc = cross_val_score(lg, X, Y, scoring='roc_auc', cv=10, n_jobs=-1)
    print('Mean ROC AUC modelo: %.3f' % np.mean(cvc)) 
    print()
def divisionDatos(X,Y):
    X_train, X_test, y_train, y_test = train_test_split(X, Y, 
                     test_size=0.7,
                     stratify=Y,
                     random_state=1)
    return X_train, X_test, y_train, y_test 
X,Y= getDatos()
X_train, X_test, y_train, y_test = divisionDatos(X,Y)
lg = LogisticRegression(solver='lbfgs',class_weight='balanced')
lg.fit(X_train,y_train)
y_predic = lg.predict(X_test)
metricas(y_test,y_predic)
La matriz de confusion es: 
[[6448 482]
[ 3 67]]
La exactitud es: 0.931
La precision de la clase 0 es: 0.999534955820803
La precision de la clase 1 es: 0.122040072859745
La exahustividad de la clase 0 es: 0.9304473304473304
La exahustividad de la clase 1 es: 0.9571428571428572
Mean ROC AUC modelo: 0.990
