
El agrupamiento jerarquico
Introducción al agrupamiento jerarquico
El agrupamiento jerarquico es una técnica de aprendizaje no supervisado que organiza los datos en una estructura de árbol, también conocida como dendrograma. Este método permite identificar clústeres anidados dentro de otros clústeres, formando una jerarquía que representa la relación entre los datos. Es ideal para visualizar cómo se agrupan los elementos y descubrir estructuras ocultas en grandes volúmenes de información.
Tipos de agrupamiento jerarquico
El agrupamiento jerárquico se divide en dos enfoques principales:
-
Divisivo: consiste en dividir iterativamente todo el conjunto de muestras en clústeres, separando cada grupo en subgrupos más pequeños hasta que cada uno contenga solo una muestra.
-
Aglomerativo: funciona de manera opuesta; se inicia considerando cada muestra como un grupo independiente y se van fusionando los grupos más cercanos hasta formar un único clúster.
Como funciona el agrupamiento jerárquico y que tipos de algoritmos existen
El agrupamiento jerárquico es una técnica de aprendizaje no supervisado que organiza los datos de forma progresiva. Comienza considerando cada muestra como un grupo individual, y luego fusiona los grupos más cercanos entre sí hasta formar un único clúster.
Dentro del agrupamiento jerárquico aglomerativo, los principales algoritmos son:
-
Enlace simple: agrupa los elementos más similares o cercanos entre sí, utilizando la distancia mínima entre clústeres.
-
Enlace completo: se basa en agrupar los miembros más disímiles, empleando la distancia máxima entre elementos de distintos grupos.
Como implementarlo en Phyton
Primer ejemplo sin usar la Liberia de KMeans
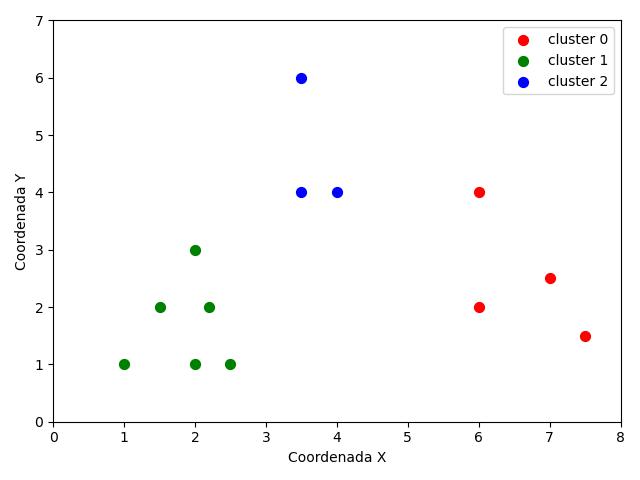
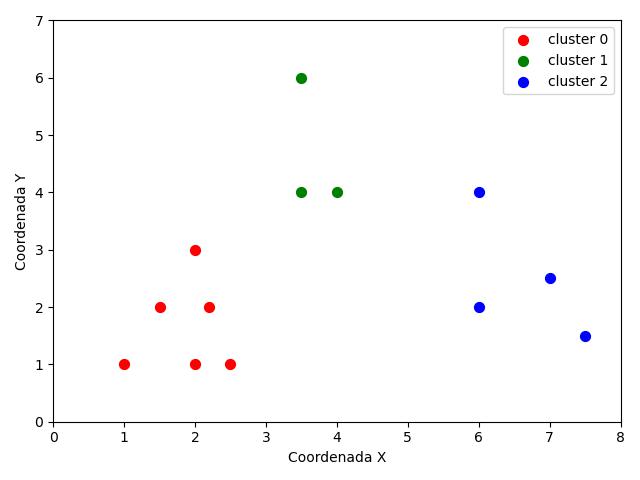
El siguiente código en Python crea y visualiza un conjunto de datos artificiales ya etiquetados en tres clústeres distintos, utilizando colores diferentes para representar cada grupo en un gráfico de dispersión (scatter plot). A continuación, se explican brevemente sus partes principales:
-
getDatos(): genera un array NumPy con 13 puntos bidimensionales (X, Y), donde la tercera columna representa la etiqueta de clúster (0, 1 o 2). -
pintarDatos(X): representa gráficamente los puntos del arrayX, separando visualmente los clústeres por color (rojo, verde y azul), con etiquetas y leyenda. -
Propósito: ilustrar la distribución visual de tres grupos de datos previamente clasificados, ideal como ejemplo introductorio en tareas de clustering o visualización de agrupamientos.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
def getDatos():
    X = np.array([[1.0, 1.0, 0],
                [2.0, 1.0, 0],
                [1.5, 2.0, 0],
                [2.5, 1.0, 0],
                [2.2, 2.0, 0],
                [2.0, 3.0, 0],
                [4.0, 4.0, 1],
                [3.5, 4.0, 1],
                [3.5, 6.0, 1],
                [6.0, 2.0, 2],
                [7.0, 2.5, 2 ],
                [6.0, 4.0, 2],
                [7.5, 1.5, 2]
                ])
    return X
def pintarDatos(X):
    plt.scatter(X[X[:,2] == 0, 0],
                X[X[:,2] == 0, 1],
                s=50, c='red',
                marker='o', edgecolor='red',
                label='cluster 0')
    plt.scatter(X[X[:,2] == 1, 0],
                X[X[:,2] == 1, 1],
                s=50, c='green',
                marker='o', edgecolor='green',
                label='cluster 1')

    plt.scatter(X[X[:,2] == 2, 0],
                X[X[:,2] == 2, 1],
                s=50, c='blue',
                marker='o', edgecolor='blue',
                label='cluster 2')
    # Mostrar el gráfico
    plt.xlim(0, 8)
    plt.ylim(0, 7)
    plt.xlabel('Coordenada X')
    plt.ylabel('Coordenada Y')
    plt.legend()
    plt.tight_layout()
    plt.legend(scatterpoints=1)
    plt.show()
X = getDatos()
pintarDatos(X)
Segundo ejemplo usando la Liberia de KMeans
El siguiente codigo en Python realiza agrupamiento no supervisado (clustering) utilizando el algoritmo KMeans del paquete scikit-learn. Los pasos clave del código son:
-
Importación de librerías necesarias para manejo de arrays, visualización y clustering.
-
Generación de datos (
getDatos): Se crean 13 muestras bidimensionales sin etiquetas predefinidas. -
Entrenamiento del modelo: Se usa
KMeans(n_clusters=3)para identificar 3 grupos diferentes en los datos. -
Predicción de etiquetas (
modelo.labels_) para asignar cada punto a un clúster. -
Visualización de los resultados con
matplotlibmediante colores diferenciados por clúster.
⚠️ Nota técnica (muy importante)
Si el código lanza un error como:
es probable que se deba a una incompatibilidad o configuración de librerías internas de hilos paralelos como OpenBLAS o MKL.
✅ Para solucionarlo, instala o actualiza el paquete threadpoolctl, ejecutando en tu terminal de Visual Studio Code:
Esto garantiza una correcta gestión de los hilos durante el entrenamiento del modelo, especialmente en entornos Windows o con múltiples bibliotecas numéricas instaladas.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
# Generar datos sin etiquetas predefinidas
def getDatos():
    X = np.array([[1.0, 1.0],
                  [2.0, 1.0],
                  [1.5, 2.0],
                  [2.5, 1.0],
                  [2.2, 2.0],
                  [2.0, 3.0],
                  [4.0, 4.0],
                  [3.5, 4.0],
                  [3.5, 6.0],
                  [6.0, 2.0],
                  [7.0, 2.5],
                  [6.0, 4.0],
                  [7.5, 1.5]])
    return X
# Pintar los clústeres predichos
def pintarDatos(X, etiquetas):
    colores = ['red', 'green', 'blue']
    for i in range(3):
        plt.scatter(X[etiquetas == i, 0],
                    X[etiquetas == i, 1],
                    s=50, c=colores[i],
                    label=f'Cluster ', edgecolor=colores[i])

    plt.xlim(0, 8)
    plt.ylim(0, 7)
    plt.xlabel('Coordenada X')
    plt.ylabel('Coordenada Y')
    plt.legend()
    plt.tight_layout()
    plt.show()
# Proceso principal
X = getDatos()
print(X)
modelo = KMeans(n_clusters=3, random_state=42)
modelo.fit(X)
etiquetas = modelo.labels_
pintarDatos(X, etiquetas)
Otras preguntas sobre el agrupamiento jerarquico
Para calcular la matriz de distancias vamos a utilizar la función pdist del submódulo spatial.distance de SciPy.
- Matriz de Distancias:
- Se comienza con una matriz de distancias que contiene las distancias entre cada par de puntos en el conjunto de datos. La distancia puede ser calculada utilizando diversas métricas, como la euclidiana o la de manhattan.
- Clústeres Iniciales:
- Cada punto se considera inicialmente como un clúster individual.
- Iteraciones de Fusión:
- En cada iteración, se buscan los dos clústeres más cercanos en la matriz de distancias.
- Estos dos clústeres se fusionan en un nuevo clúster, y la matriz de distancias se actualiza para reflejar la distancia entre el nuevo clúster y los clústeres restantes.
- Repeticiones:
- Se repite el proceso de búsqueda y fusión hasta que todos los puntos pertenecen a un solo clúster.
- Dendrograma:
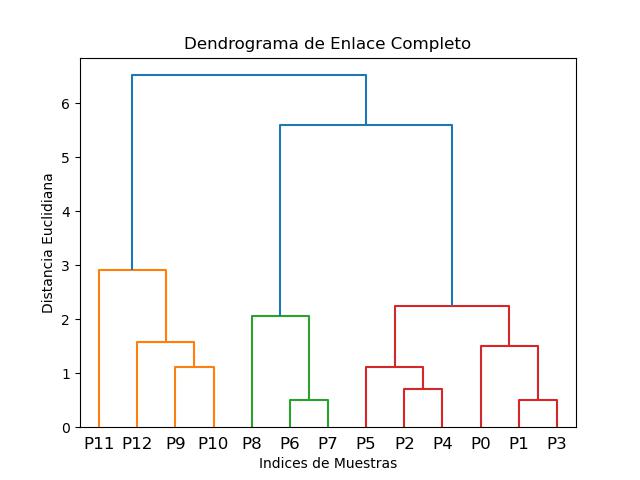
- A medida que se realizan las fusiones, se construye un dendrograma que representa la jerarquía de los clústeres. La altura en la que se une un par de clústeres en el dendrograma refleja la distancia entre ellos.
import pandas as pd
import numpy as np
from IPython.display import display
from scipy.cluster.hierarchy import linkage
from scipy.spatial.distance import pdist, squareform
import matplotlib.pyplot as plt
from scipy.cluster.hierarchy import dendrogram
variables = ['X','Y']
labels = ['P0','P1','P2','P3','P4','P5','P6','P7','P8','P9','P10','P11','P12']
def getDatos():
    X = np.array([[1.0, 1.0, 0],
                [2.0, 1.0, 0],
                [1.5, 2.0, 0],
                [2.5, 1.0, 0],
                [2.2, 2.0, 0],
                [2.0, 3.0, 0],
                [4.0, 4.0, 1],
                [3.5, 4.0, 1],
                [3.5, 6.0, 1],
                [6.0, 2.0, 2],
                [7.0, 2.5, 2],
                [6.0, 4.0, 2],
                [7.5, 1.5, 2]
                ])
    return X

def displayMatrizSimetrica(matriz_simetrica,labels):
    matriz_simetrica= pd.DataFrame(matriz_simetrica,columns=labels, index=labels)
    display(matriz_simetrica)
def enlaceCompleto(X):
    enlace_completo = linkage(pdist(X, metric='euclidean'), method='complete')
    enlace_completo=pd.DataFrame(enlace_completo,
             columns=['índice 1', 'índice 2',
                      'distancia', 'numero de observaciones'],
             index=['cluster %d' % (i + 1)
                    for i in range(enlace_completo.shape[0])])
    return enlace_completo
def setDendograma(enlace_completo,labels):
    dendrogram(enlace_completo,labels=labels)
    plt.ylabel('Distancia Euclidiana')
    plt.xlabel('Indices de Muestras')
    plt.title('Dendrograma de Enlace Completo')
    plt.show()
X = getDatos()
X = X[:,:2]
X = pd.DataFrame(X, columns=variables, index=labels)
# Mostramos el DataFrame en forma de tabla
print("Muestras de datos: ")
display(X)
print("Matriz simetrica: ")
displayMatrizSimetrica(squareform(pdist(X, metric='euclidean')),labels)
enlace_completo = enlaceCompleto(X)
print("Tabla de agrupamiento de clusters: ")
display(enlace_completo)
setDendograma(enlace_completo,labels)
Conjunto de datos:
       X    Y
P0   1.0  1.0
P1   2.0  1.0
P2   1.5  2.0
P3   2.5  1.0
P4   2.2  2.0
P5   2.0  3.0
P6   4.0  4.0
P7   3.5  4.0
P8   3.5  6.0
P9   6.0  2.0
P10  7.0  2.5
P11  6.0  4.0
P12  7.5  1.5
           P0        P1        P2        P3        P4        P5  ...        P7        P8        P9       P10       P11       P12
P0   0.000000  1.000000  1.118034  1.500000  1.562050  2.236068  ...  3.905125  5.590170  5.099020  6.184658  5.830952  6.519202
P1   1.000000  0.000000  1.118034  0.500000  1.019804  2.000000  ...  3.354102  5.220153  4.123106  5.220153  5.000000  5.522681
P2   1.118034  1.118034  0.000000  1.414214  0.700000  1.118034  ...  2.828427  4.472136  4.500000  5.522681  4.924429  6.020797
P3   1.500000  0.500000  1.414214  0.000000  1.044031  2.061553  ...  3.162278  5.099020  3.640055  4.743416  4.609772  5.024938
P4   1.562050  1.019804  0.700000  1.044031  0.000000  1.019804  ...  2.385372  4.205948  3.800000  4.825971  4.294182  5.323533
P5   2.236068  2.000000  1.118034  2.061553  1.019804  0.000000  ...  1.802776  3.354102  4.123106  5.024938  4.123106  5.700877
P6   4.242641  3.605551  3.201562  3.354102  2.690725  2.236068  ...  0.500000  2.061553  2.828427  3.354102  2.000000  4.301163
P7   3.905125  3.354102  2.828427  3.162278  2.385372  1.802776  ...  0.000000  2.000000  3.201562  3.807887  2.500000  4.716991
P8   5.590170  5.220153  4.472136  5.099020  4.205948  3.354102  ...  2.000000  0.000000  4.716991  4.949747  3.201562  6.020797
P9   5.099020  4.123106  4.500000  3.640055  3.800000  4.123106  ...  3.201562  4.716991  0.000000  1.118034  2.000000  1.581139
P10  6.184658  5.220153  5.522681  4.743416  4.825971  5.024938  ...  3.807887  4.949747  1.118034  0.000000  1.802776  1.118034
P11  5.830952  5.000000  4.924429  4.609772  4.294182  4.123106  ...  2.500000  3.201562  2.000000  1.802776  0.000000  2.915476
P12  6.519202  5.522681  6.020797  5.024938  5.323533  5.700877  ...  4.716991  6.020797  1.581139  1.118034  2.915476  0.000000

[13 rows x 13 columns]
            índice 1  índice 2  distancia  numero de observaciones
cluster 1        1.0       3.0   0.500000                      2.0
cluster 2        6.0       7.0   0.500000                      2.0
cluster 3        2.0       4.0   0.700000                      2.0
cluster 4        5.0      15.0   1.118034                      3.0
cluster 5        9.0      10.0   1.118034                      2.0
cluster 6        0.0      13.0   1.500000                      3.0
cluster 7       12.0      17.0   1.581139                      3.0
cluster 9       16.0      18.0   2.236068                      6.0
cluster 10      11.0      19.0   2.915476                      4.0
cluster 11      20.0      21.0   5.590170                      9.0
cluster 12      22.0      23.0   6.519202                     13.0
La librería de scikit-learn dispone de una implementación Agglomerative Clustering que nos permite elegir el número de grupos que queremos devolver.
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import AgglomerativeClustering
def getDatos():
    X = np.array([[1.0, 1.0],
                [2.0, 1.0],
                [1.5, 2.0],
                [2.5, 1.0],
                [2.2, 2.0],
                [2.0, 3.0],
                [4.0, 4.0],
                [3.5, 4.0],
                [3.5, 6.0],
                [6.0, 2.0],
                [7.0, 2.5],
                [6.0, 4.0],
                [7.5, 1.5]
                ])
    return X

def pintarCluster(X,y_agglomerative):
    plt.scatter(X[y_agglomerative == 0, 0],
                X[y_agglomerative == 0, 1],
                s=50, c='red',
                marker='o', edgecolor='red',
                label='cluster 0')
    plt.scatter(X[y_agglomerative == 1, 0],
                X[y_agglomerative == 1, 1],
                s=50, c='green',
                marker='o', edgecolor='green',
                label='cluster 1')

    plt.scatter(X[y_agglomerative == 2, 0],
                X[y_agglomerative == 2, 1],
                s=50, c='blue',
                marker='o', edgecolor='blue',
                label='cluster 2')
    # Mostrar el gráfico
    plt.xlim(0, 8)
    plt.ylim(0, 7)
    plt.xlabel('Coordenada X')
    plt.ylabel('Coordenada Y')
    plt.legend()
    plt.tight_layout()
    plt.legend(scatterpoints=1)
    plt.show()

def aglome(X):
    agglomerative = AgglomerativeClustering(n_clusters=3,
                             metric='euclidean',
                             linkage='complete')
    agglomerative.fit(X)
    y_agglomerative = agglomerative.fit_predict(X)
    return agglomerative,y_agglomerative

X=getDatos()
agglomerative,y_agglomerative= aglome(X)
print('Cluster labels: %s' % y_agglomerative)
pintarCluster(X,y_agglomerative)
Cluster labels: [1 1 1 1 1 1 2 2 2 0 0 0 0]