

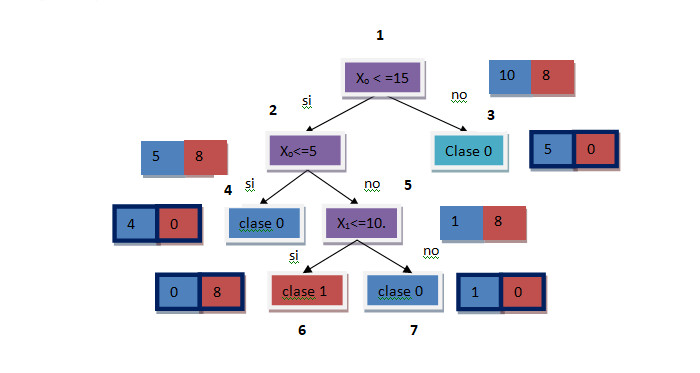
El arbol de decisiones es uno de los algoritmos más populares en aprendizaje automático debido a su simplicidad, interpretabilidad y eficacia. Se utiliza tanto para problemas de clasificación como de regresión, y su funcionamiento se basa en dividir los datos en subconjuntos más pequeños siguiendo criterios específicos, hasta llegar a resultados fácilmente interpretables.
¿Qué es un arbol de decisiones?
Un árbol de decisiones es un modelo que organiza las decisiones en una estructura jerárquica de nodos. Cada nodo representa una pregunta o condición sobre una variable, y las ramas son las posibles respuestas. El objetivo del árbol es dividir los datos en subconjuntos homogéneos, donde las muestras de cada subconjunto sean lo más similares posible.
Por ejemplo, en un problema de clasificación, el árbol determinará a qué clase pertenece una muestra a través de una secuencia de decisiones.
Algoritmo CART (Classification and Regression Tree)
El algoritmo CART es uno de los más utilizados para construir árboles de decisiones. Se utiliza tanto para clasificación como para regresión. Sus pasos principales son:
- Seleccionar la característica de división:
-
- Busca la característica que minimice la impureza (por ejemplo, usando el índice Gini).
- Realizar divisiones binarias:
-
- Cada nodo se divide en dos ramas con base en un umbral.
- Continuar el proceso recursivamente:
-
- Se repite hasta que los datos de un nodo sean completamente homogéneos o se alcance un criterio de parada (como una profundidad máxima).
- Poda del árbol:
-
- Reduce el tamaño del árbol eliminando ramas poco importantes para evitar el sobreajuste.
Las impurezas miden qué tan “mezclados” están los datos en cada nodo del árbol, es decir son métricas clave en los árboles de decisión utilizadas para evaluar el nivel de mezcla de las muestras dentro de un nodo. Cuanto menor sea la impureza, más homogéneas serán las muestras en ese nodo, lo que mejora la precisión del modelo y facilita la toma de decisiones basadas en dichas muestras. Reducir las impurezas es esencial para construir árboles de decisión efectivos y confiables.
Entropía:
-
- Se calcula como la suma de las proporciones de cada clase multiplicada por el logaritmo de esas proporciones. Un nodo con entropía cero es completamente puro si todas las muestras pertenecen a la misma clase, mientras que un nodo con entropía más alta es más impuro y contiene una mezcla de clases, y es máxima si tenemos una distribución uniforme:
- Fórmula:
-
-
- Donde:
-
-
-
-
- c es el número de clases
- P es la proporción de las muestras que pertenecen a una clase donde t es número de elementos e i es el número de elementos por clase.
- En un ajuste de clases binario la entropía es 0 (nodos puros) si:
- Pi=1(i|t)=1 donde todos los elementos de la clase 1 son iguales a t por lo que la en clase contraria siempre se cumple que Pi=0(i|t)=0
- Si las clases están distribuidas de forma uniforme la entropía es 1
- Pi=1(i|t)=0.5 entonces la clase contraria Pi=0(i|t)=0.5
-
-
Índice Gini:
-
- La impureza de Gini mide como están mezcladas están las clases en un nodo. Se calcula como la suma de los cuadrados de las proporciones de cada clase en el nodo. Cuanto más cerca esté el valor de Gini de cero, más puro es el nodo donde todas las muestras pertenecen a la misma clase, y cuanto más cerca esté de uno, más impuro es decir las muestras están igualmente distribuidas en varias clases..
- Formula:
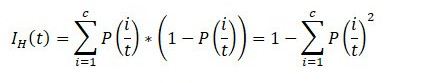
Error de clasificación:
-
- Es la proporción de muestras en el nodo que no pertenecen a la clase más común. Cuanto mayor sea el error de clasificación, más impuro será el nodo.
- Fórmula:
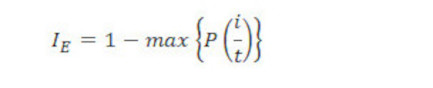
Cálculo de la ganancia de la información
-
- Es una técnica utilizada en los árboles de decisión para determinar cuál es la característica óptima para dividir un conjunto de datos en un nodo específico del árbol. Su objetivo es medir cuánta información nueva se gana al dividir los datos en función de una característica en particular.
- Formula:
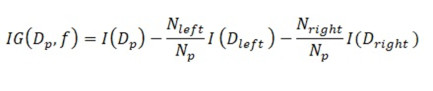
¿Cómo funciona un arbol de decisiones?
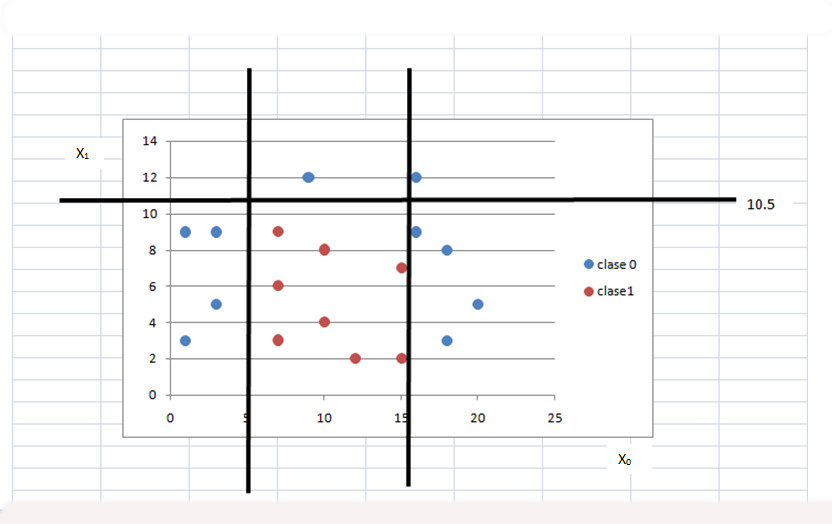
Un arbol de decisiones es un algoritmo de aprendizaje automático que toma decisiones basadas en una serie de preguntas sucesivas, dividiendo los datos en subconjuntos más pequeños para llegar a una conclusión. Es ampliamente utilizado tanto en problemas de clasificación como de regresión debido a su capacidad para interpretar y analizar datos complejos de manera estructurada.
A continuación, explicamos el funcionamiento de un árbol de decisiones paso a paso:
Con 18 puntos de los cuales 10 (Azules) son de la clase 0 y 8 (Rojos) de la clase 1
1. Nodo Raíz: El punto de partida
El proceso comienza con un nodo raíz, que representa todo el conjunto de datos de entrenamiento. Este nodo inicial incluye todos los puntos de datos, como los 18 puntos del ejemplo, donde 10 son de la clase 0 (Azules) y 8 de la clase 1 (Rojos).
2. Selección de características: La división del nodo
En cada paso, el árbol selecciona una característica del conjunto de datos para dividir el nodo actual en dos o más nodos hijos. Esta selección se basa en el criterio que mejor separa las clases utilizando medidas de pureza como:
- Índice Gini: Evalúa la heterogeneidad de los datos en un nodo.
- Entropía: Mide la incertidumbre de los datos.
- Ganancia de información: Calcula la reducción de la impureza después de una división.
El objetivo es maximizar la homogeneidad de los nodos hijos y minimizar la impureza dentro de ellos.
3. Criterio de parada: Cuándo dejar de dividir
El árbol deja de dividir un nodo en nodos hijos cuando se cumple un criterio de parada. Algunos criterios comunes son:
- Haber alcanzado una profundidad máxima predefinida.
- Tener un número mínimo de muestras en un nodo.
- Lograr un nivel deseado de pureza en los nodos hijos.
Por ejemplo, si se alcanzan nodos con solo datos de una clase, el árbol considera que el nodo es puro y deja de dividirlo.
4. Etiquetado de nodos hoja
Una vez que se alcanza un nodo hoja (nodo final), se asigna una etiqueta de clase para problemas de clasificación o un valor numérico en el caso de problemas de regresión. Por ejemplo:
- Si un nodo contiene únicamente puntos de la clase 0 (Azules), el nodo se etiqueta como “Clase 0”.
- Si contiene solo datos de la clase 1 (Rojos), el nodo se etiqueta como “Clase 1”.
5. Predicción: ¿Cómo predice un árbol de decisiones?
Para hacer una predicción sobre un nuevo punto de datos, se sigue el árbol desde el nodo raíz hasta un nodo hoja, evaluando las condiciones en cada nodo. Una vez que se alcanza el nodo hoja, su etiqueta o valor se utiliza como la predicción final.
Ejemplo práctico:
Imagina que deseas clasificar un punto nuevo:
- El árbol evalúa la primera característica en el nodo raíz.
- Dependiendo del resultado, el árbol sigue hacia un nodo hijo correspondiente.
- Este proceso se repite hasta llegar al nodo hoja, donde se encuentra la predicción.
Resumen del funcionamiento del árbol de decisiones
- Nodo raíz: Representa todo el conjunto de datos.
- División: Se seleccionan características para dividir los datos en función de un criterio de pureza (como Gini o entropía).
- Criterio de parada: Define cuándo detener la división.
- Etiquetado: Los nodos hoja reciben etiquetas de clase o valores numéricos.
- Predicción: Para clasificar un dato nuevo, el árbol sigue las condiciones hasta un nodo hoja.
Ventajas y desventajas del arbol de decisiones
Ventajas:
- Fácil de interpretar y visualizar.
- No requiere normalización de datos.
- Puede manejar tanto datos categóricos como numéricos.
- Funciona bien con problemas no lineales.
Desventajas:
- Es propenso al sobreajuste, especialmente en árboles grandes.
- Puede ser inestable, ya que pequeñas variaciones en los datos pueden cambiar la estructura del árbol.
- Generalmente no alcanza el nivel de precisión de modelos más avanzados como Random Forest o Gradient Boosting.
Conclusión
El arbol de decisiones es una herramienta poderosa y fácil de interpretar en aprendizaje automático. Con conceptos como la entropía, el índice Gini y algoritmos como CART, los árboles dividen los datos en subconjuntos homogéneos, proporcionando predicciones claras y comprensibles. Además, su implementación con bibliotecas como scikit-learn facilita su uso en problemas reales, desde clasificación de datos hasta toma de decisiones complejas.


