
Las Maquinas de Soporte Vectorial (SVM) son una técnica en aprendizaje automático diseñada para encontrar el hiperplano óptimo que separa diferentes clases en un conjunto de datos. Este hiperplano maximiza el margen de separación entre las clases, garantizando una clasificación más precisa y efectiva.
Para que sirven las máquinas de soporte
Las SVM son algoritmos versátiles que se utilizan en diversas aplicaciones, incluyendo:
- Clasificación: Diferenciar entre dos o más clases en un conjunto de datos.
- Regresión: Realizar predicciones continúas basadas en datos de entrenamiento.
- Detección de anomalías: Identificar puntos que no encajan con el resto de los datos.
- Problemas no lineales: Utilizando kernels, las SVM son capaces de manejar datos que no pueden ser separados linealmente.
- Selección de características relevantes: Pueden identificar las variables más importantes en un conjunto de datos.
Aplicaciones comunes:
- Reconocimiento de patrones (por ejemplo, reconocimiento facial).
- Búsqueda de fronteras de decisión óptimas en problemas complejos.
Las SVM son valoradas por su alta precisión y capacidad para manejar conjuntos de datos complejos, incluso en situaciones donde otras técnicas, como la regresión logística o los árboles de decisión, podrían fallar.
Cómo funcionan las maquinas de soporte
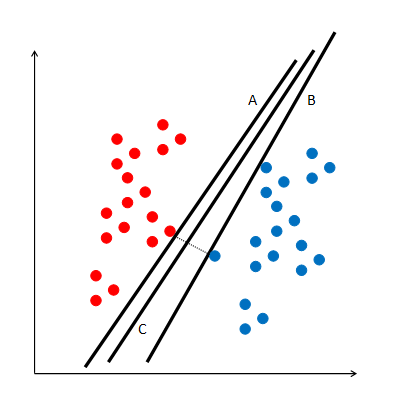
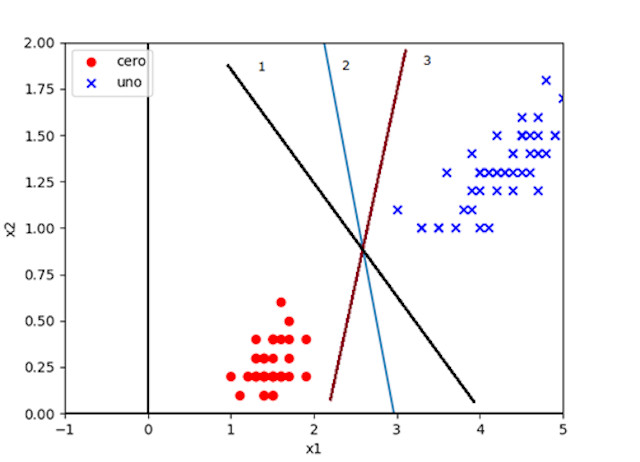
El objetivo principal de una SVM es encontrar el hiperplano que divide las clases de la mejor manera posible. Para entenderlo mejor, consideremos un ejemplo donde evaluamos tres posibles rectas: A, B y C.
- Las rectas A y B son cercanas a las clases, pero no logran maximizar la separación.
- La recta C, en cambio, está ubicada en el punto intermedio entre ambas clases y tiene el margen máximo de separación. Esto la convierte en la mejor opción.
Proceso para encontrar el hiperplano óptimo:
- Identificar los puntos más cercanos entre las dos clases: Estos puntos son cruciales porque determinan el margen.
- Trazar una línea que conecte esos puntos:
- La SVM busca el margen máximo entre las dos clases, utilizando estas líneas como referencia.
- Encontrar una línea perpendicular (hiperplano): Esta línea actúa como la frontera de decisión, dividiendo las clases con el mayor margen posible.
Conceptos básicos de las maquinas de soporte:
- Vectores de Soporte:
- Son los puntos más cercanos al hiperplano en ambas clases. Estos puntos determinan la posición y orientación del hiperplano.
- Las líneas paralelas al hiperplano que pasan por estos puntos delimitan el margen.
- Hiperplano:
- Es el plano que separa las clases en el espacio de características. En problemas lineales, es una línea en 2D o un plano en 3D.
- Margen:
- Es la distancia entre el hiperplano y los vectores de soporte.
- Un margen amplio garantiza una mejor generalización del modelo, mientras que un margen pequeño puede indicar un modelo menos robusto.
Ventajas de las Máquinas de Soporte Vectorial
- Precisión: SVM generalmente ofrece un rendimiento superior en comparación con clasificadores como la regresión logística o los árboles de decisión.
- Capacidad para manejar datos complejos: Gracias al uso de kernels, las SVM pueden manejar relaciones no lineales entre las variables.
- Flexibilidad: Funciona tanto para clasificación como para regresión, y se adapta a diferentes tipos de datos.
¿Cómo se implementa en scikit learn con Python?
import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets
from matplotlib.colors import ListedColormap
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.metrics import confusion_matrix
from sklearn.metrics import accuracy_score
from sklearn.svm import SVC
import matplotlib.pyplot as pyplot
def getDatos():
  #Lectura de datos
    iris = datasets.load_iris()
    X = iris.data[:, [2, 3]]
    y = iris.target
    X = X[(y == 0) | (y == 1)] #Elimina las filas de la clase 2
    y = y[(y == 0) | (y == 1)]
    return X,y
class FuncionMatematica(object):
    def __init__(self,minEscalaEjeX,maxEscalaEjeX,minEscalaEjeY,maxEscalaEjeY,minRangoValoresX,maxRangoValoresX,W):
        self.x = range(minRangoValoresX,maxRangoValoresX)
        self.minEscalaEjeX = minEscalaEjeX
        self.minEscalaEjeX = minEscalaEjeX
        self.maxEscalaEjeX = maxEscalaEjeX
        self.minEscalaEjeY = minEscalaEjeY
        self.maxEscalaEjeY = maxEscalaEjeY
        self.minRangoValoresX = minRangoValoresX
        self.maxRangoValoresX = maxRangoValoresX
        self.W=W
    def funcion(self,x):
       z = float((-self.W[0]-self.W[1]*x)/self.W[2])
       return z
    def dibujarGrafica(self):
        y2= [self.funcion(x) for x in self.x ]
        pyplot.plot(self.x, y2)
        # Establecer el color de los ejes.
        pyplot.axhline(0, color="black")
        pyplot.axvline(0, color="black")
        # Escala de los ejes
        pyplot.xlim(self.minEscalaEjeX, self.maxEscalaEjeX)
        pyplot.ylim(self.minEscalaEjeY, self.maxEscalaEjeY)
        #Guardar gráfico como imágen PNG.
def pintarDatos(X,W):
            pyplot.scatter(X[:50, 0], X[:50, 1],
                    color='red', marker='o', label='cero')
            pyplot.scatter(X[50:100, 0], X[50:100, 1],
                    color='blue', marker='x', label='uno')
            pyplot.xlabel('x1')
            pyplot.ylabel('x2')
            plt.legend(loc='upper left')
            for i in  W:
             fn = FuncionMatematica(-1,5,0,2,1,5,i)
             fn.dibujarGrafica()
            pyplot.show()
X,Y = getDatos()
#Division del conjunto de datos
X_train, X_test, Y_train, Y_test = train_test_split(
    X, Y, test_size=0.3, random_state=1, stratify=Y)
svm = SVC(kernel='linear', C=0.1, random_state=1)
#Entrenamiento del conjunto de datos
svm.fit(X_train,Y_train)
# s=svm.coef_
# sesgo=svm.intercept_
# donde s tiene los valores W1 y W2 en s[0] y sesgo tiene el valor W0 en sesgo[0]
s=svm.coef_
sesgo=svm.intercept_
weights= []
weights.append(np.hstack((sesgo[0],svm.coef_[0])))
pintarDatos(X,weights)
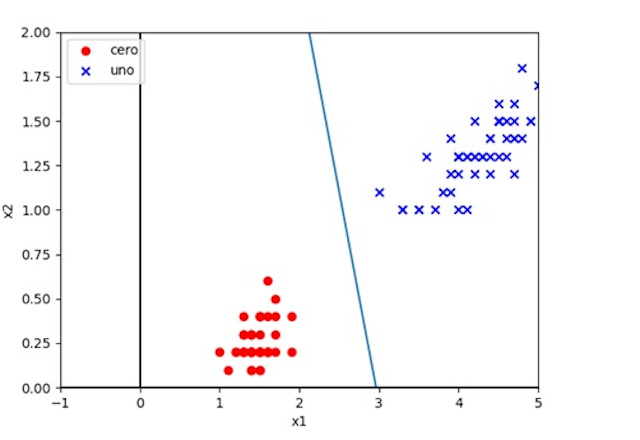
Este código implementa un modelo de Máquinas de Soporte Vectorial (SVM) para resolver un problema de clasificación binaria basado en el conjunto de datos Iris. Además, genera una representación gráfica de los datos clasificados y las fronteras de decisión utilizando funciones matemáticas personalizadas. A continuación, se desglosa el funcionamiento del código:
El código implementa un modelo de Máquinas de Soporte Vectorial (SVM) para resolver un problema de clasificación binaria utilizando el conjunto de datos Iris. Filtra las clases 0 y 1, selecciona dos características (x2 y x3), y divide los datos en entrenamiento y prueba. Luego entrena un modelo SVM con un kernel lineal y calcula los pesos (W1,W2) y el sesgo (W0).
Finalmente, genera una visualización gráfica de las muestras de cada clase y las fronteras de decisión generadas por el modelo, utilizando funciones matemáticas personalizadas para mostrar cómo el SVM separa las clases en el espacio bidimensional. El código permite observar la clasificación y los márgenes del modelo de forma visual.
Otro ejemplo:
Tenemos un conjunto de datos llamado Breast Cancer Wiconsinn que tiene 569 muestras de células buenas y malas, donde la columna 1 tiene el valor de la etiqueta que corresponde al tipo de célula y las columnas 3 a 32 tienen las 30 características de cada célula.
import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets
from matplotlib.colors import ListedColormap
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.metrics import confusion_matrix
from sklearn.metrics import accuracy_score
from sklearn.svm import SVC
from sklearn.preprocessing import LabelEncoder
import pandas as pd
def getDatos():
  #Lectura de datos
    datos = pd.read_csv('https://archive.ics.uci.edu/ml/'
                 'machine-learning-databases'
                 '/breast-cancer-wisconsin/wdbc.data', header=None)
    X = datos.loc[:,2:].values
    Y = datos.loc[:,1].values
    #Transformacion las etiquetas de Y a valores 0 y 1
    labelEncoder = LabelEncoder()
    Y = labelEncoder.fit_transform(Y)
    return X,Y
def divisionDatos(X, Y):
    X_train, X_test, y_train, y_test = train_test_split(
    X, Y, test_size=0.3, random_state=1, stratify=Y)
    return X_train, X_test, y_train, y_test
def getMetricas(Y_predic,Y_test):
    print("Numero de datos mal clasificados: ")
    print((Y_predic != Y_test).sum())
    exactitud = accuracy_score(Y_test,Y_predic)
    print("Exactitud del modelo:")
    print(exactitud)
    print('La matriz de confusion es: ')
    print(confusion_matrix(Y_test,Y_predic))
def normalizacion(X_train,X_test):
    #Normalizamos los datos
    normalizar = StandardScaler()
    X_train_std = normalizar.fit_transform(X_train)
    X_test_std = normalizar.transform(X_test)
    return X_train_std, X_test_std

X,Y = getDatos()
X_train, X_test, y_train, y_test= divisionDatos(X,Y)
X_train_std, X_test_std=normalizacion(X_train,X_test)
svm = SVC(kernel='linear', C=0.1, random_state=1)
#Entrenamiento del conjunto de datos
svm.fit(X_train_std,y_train)
y_predict=svm.predict(X_test_std)
getMetricas(y_predict,y_test)
Numero de datos mal clasificados:
7
Exactitud del modelo:
0.9590643274853801
La matriz de confusion es:
[[106   1]
 [  6  58]]
¿Qué diferencias existen con la regresión logística?
A continuación, se presentan las diferencias principales entre las Máquinas de Soporte Vectorial (SVM) y la Regresión Logística, destacando sus características y aplicaciones de forma clara y optimizada:
- Función de decisión:
- SVM: Busca un hiperplano que maximiza el margen entre las clases, estableciendo una frontera clara de decisión.
- Regresión Logística: Modela la probabilidad de que una observación pertenezca a una clase, aplicando un umbral de probabilidad para clasificar.
- Fronteras de decisión:
- SVM: Puede encontrar fronteras no lineales mediante el uso de kernels, lo que la hace adecuada para datos más complejos.
- Regresión Logística: Se limita a fronteras lineales, a menos que se transformen las variables de entrada.
- Manejo de desequilibrio de clases:
- SVM: Tiene dificultades con conjuntos de datos desequilibrados, ya que tiende a centrarse en la clasificación de la clase mayoritaria.
- Regresión Logística: Maneja mejor el desequilibrio, permitiendo ajustar los umbrales de probabilidad para mejorar la clasificación de la clase minoritaria.
- Sensibilidad a valores atípicos:
- SVM: Es más sensible a valores atípicos, ya que se enfoca en los vectores de soporte más cercanos al margen.
- Regresión Logística: Tiene una mayor robustez frente a valores atípicos, lo que la hace más adecuada en datos con ruido.
- Función de coste:
- SVM: Utiliza una función de coste basada en el margen, lo que la hace menos sensible a algunos valores atípicos.
- Regresión Logística: Emplea una función de coste logarítmica, que penaliza con más fuerza los valores atípicos extremos.
- Susceptibilidad al sobreajuste:
- SVM: Es más susceptible al sobreajuste, especialmente al utilizar kernels no lineales o conjuntos de datos con muchas características en relación al tamaño del conjunto de entrenamiento.
- Regresión Logística: Tiende a ser más resistente al sobreajuste, generalizando mejor en situaciones con datos limitados o con ruido.